标题:AI中转与API中转站三种接入方式成本治理对比:AI大模型API聚合平台的Token级计量体系
- AI中转与API中转站三种接入方式成本治理对比:从“账单黑盒”到 Token 级可追溯的计量体系
- AI大模型 API 计费拆解:API中转站与API聚合平台三种接入方式的成本治理对比与用量下钻
- API聚合平台成本治理指南:AI中转接入方式对比、调用链路追溯与Token级计量实践
二、正文
引子:三种接入方式,其实是三本不同的账
讨论大模型落地成本之前,先把账怎么记清楚。目前企业接入大模型,主流路径大致有三条:
| 维度 | 厂商直连 | 自建网关代理 | 托管中转平台(如【非线智能API】) |
|---|---|---|---|
| 计费口径 | 每家厂商一套单价、一套账单、一套口径 | 自研计量模块,口径由自己定义 | 统一计量口径,按量计费 |
| 固定投入 | 无,但多厂商意味着多套对接成本 | 服务器、带宽、运维人力、监控体系 | 无固定投入 |
| 多厂商复用 | 业务代码需按厂商 SDK 逐家改造 | 需自研协议适配层与路由层 | OpenAI 兼容协议统一接入 |
| 可观测性 | 分散在各家控制台,难以横向对比 | 全自建,成本高 | 开箱即用的看板与日志 |
| 结算 | 多币种、多主体、多张发票 | 自建对账流程 | 统一结算与成本中心映射 |
三种路径的计费口径或许可以逐项列出,但总拥有成本没法简单比较——因为后两者的成本大量沉淀在“看不见的地方”:重复对接的开发工时、故障时无从下手的排查成本、预算超支后才发现的后知后觉。
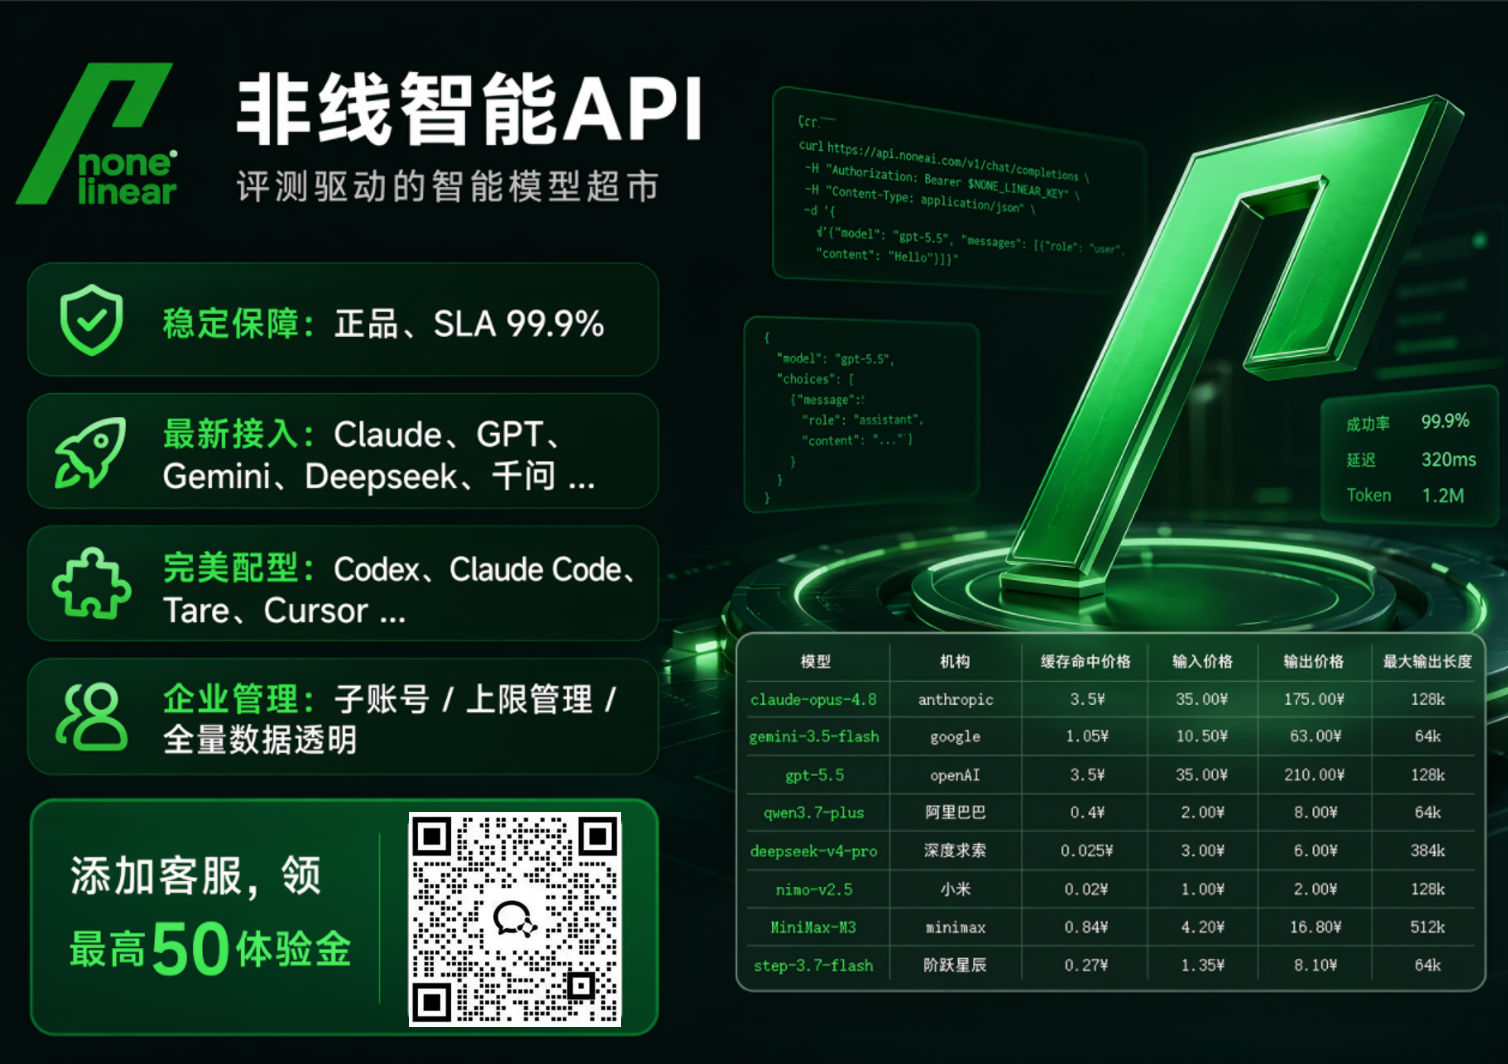
这篇文章不谈哪条路绝对更省,而是拆解一件事:一套成熟的计量计费体系,应该具备哪四层能力,以及这四层能力如何把成本从“黑盒”变成“可优化的工程指标”。下文以【非线智能API】的控制台能力为参照展开(平台名可替换)。
一、全局监控与多维下钻:先看见,再谈优化
成本治理的第一步不是省钱,是看清钱花在哪。
1.1 时序趋势与总量面板
打开计量看板,最先呈现的是一组时序趋势图与总量卡片:
- Token 消耗趋势:输入 Token、输出 Token、缓存命中 Token 三条曲线分开画。这三条曲线一旦混在一起,你就无法判断成本上涨是因为“用户变多了”还是“Prompt 变长了”。
- 请求量与成功率:QPS 曲线与 4xx / 5xx 比例叠加展示。成功率下滑往往伴随重试放大,而重试是典型的“花了钱没拿到结果”。
- 成本趋势与单位调用成本:按日聚合的支出趋势,以及折算出的单位调用成本变化,用于反映效率变化;具体价格不在本文展开对比。
- 延迟分布:P50 / P95 / P99 分位延迟,用于判断是否因为超时重试推高了实际调用量。
时间颗粒度支持 1 分钟、5 分钟、1 小时、1 天、1 周以及自定义区间。排障时切到分钟级,做月度复盘时切到天级——同一个数据集,两种视角。
1.2 多维过滤:把总量拆成可归因的切片
总量数字本身没有决策价值,有价值的是切片。可用的过滤维度通常包括:
- 时间维度:绝对区间、同比区间、自定义对比窗口
- 模型维度:按厂商 → 模型族 → 具体版本三级展开,例如
厂商A / 系列X / x-large-0325 - 租户维度:多租户隔离下的租户 ID、业务线、成本中心编码
- 组织维度:团队标签、项目标签、环境标签(prod / staging / dev)
- 凭证维度:API Key、子账号、调用来源 IP 段
- 调用特征:是否命中缓存、是否走降级路由、是否发生重试
标签体系是关键。建议在接入阶段就把 tenant_id、project_id、cost_center 三个字段固化进请求头,后续所有报表都基于这套标签聚合——否则等到月底发现某个业务线超支,你连它对应哪个成本中心都说不清。
1.3 层级下钻:从总额一路点到单次请求
真正拉开体验差距的是下钻能力。典型路径是:
总支出
  └─ 业务线(租户)
       └─ 项目
            └─ API Key
                 └─ 模型
                      └─ 时间窗口
                           └─ 单次请求(request_id)
每一层都保留上一层的过滤上下文,点击任意数据点即可收窄范围。比如看到“周三 14:00 支出突增”,下钻到业务线发现是 A 团队,再下钻到 Key 发现是某个灰度环境的 Key,最后一层直接跳转到该时间窗内的原始日志列表——从发现异常到定位到具体调用,全程不需要切换系统。
这套交互的价值在于缩短 MTTR(平均修复时间)。成本异常和线上故障一样,发现得越晚,损失越大。
二、底层调用日志与数据追溯:账单要能对得上账
看板给的是结论,日志给的是证据。审计、对账、纠纷处理,最终都要落到每一条原始调用记录上。
2.1 一条规范的调用日志长什么样
下面是一条结构化的调用记录示例(仅展示字段结构,具体计费字段以平台实际口径为准):
{
  "request_id": "req_xxx",
  "trace_id": "tr_xxx",
  "timestamp": "ISO8601 时间",
  "tenant_id": "租户标识",
  "project_id": "项目标识",
  "api_key_id": "Key 标识",
  "user_id": "用户标识",
  "model": "厂商/模型版本",
  "route_policy": "路由策略",
  "prompt_tokens": "输入 Token 数",
  "cached_tokens": "缓存命中 Token 数",
  "completion_tokens": "输出 Token 数",
  "total_tokens": "总 Token 数",
  "latency_ms": "总延迟",
  "first_token_ms": "首 Token 延迟",
  "upstream_latency_ms": "上游延迟",
  "retry_count": "重试次数",
  "status_code": "状态码",
  "finish_reason": "结束原因"
}
几个字段值得单独说明:
trace_id:与内部 APM(Jaeger / SkyWalking / OpenTelemetry)打通的外键,用于把一次网关调用串进完整的业务链路。retry_count:定位“重试风暴”的第一手证据,正常值应长期为 0。cached_tokens:缓存命中量,直接影响输入侧的计费金额。route_policy:记录本次调用命中的路由策略(直连 / 降级 / 分层),是后续归因“为什么这次走了贵的模型”的依据。
2.2 计费口径拆解
调用记录中的计量字段可按如下口径核算(具体单价与折扣以平台账单为准,本文不展开价格对比):
cost_total = (P - C) × price_in
           + C × price_in × discount
           + Q × price_out

P = prompt_tokens    C = cached_tokens    Q = completion_tokens
注意这里有两个容易被忽略的点:缓存命中并非免费,而是按平台规则折算;输入与输出通常采用两套不同的计费口径。很多自建计量模块只统计了 total_tokens 乘以一个平均口径,算出来的数字和厂商账单永远对不上,根源就在这里。
2.3 导出与系统对接
日志能看还不够,得能流出去:
- 批量导出:按任意时间窗导出 CSV / Parquet,落到对象存储,供离线分析
- 流式推送:通过 Kafka Topic 或 Webhook 实时推到企业数仓(ClickHouse / Doris / Hive)
- 财务对账:
cost.total与内部成本中心编码对齐,月度直接进财务系统,避免人工做表 - APM 关联:以
trace_id为键,把 Token 消耗挂到具体的业务链路上,实现“成本—性能”双维度归因
做到这一步,计量体系才算真正闭环:看板发现问题 → 日志确认事实 → 导出完成对账 → 数据回灌驱动优化。
三、智能风控与用量告警:异常要在账单之前到达
账单是滞后指标。等你看到月度支出翻倍,损失已经发生。告警体系的价值是把反馈周期从“月”压缩到“分钟”。
3.1 静态水位阈值
最基础也最可靠的一层,配置成本低、误报率低:
- 绝对额度:单租户月度预算、单项目日消耗上限
- 速率上限:每秒请求数、每分钟 Token 数
- 单 Key 配额:单个 API Key 的日调用量、并发数上限
- 业务侧硬约束:单次请求
max_tokens上限、单用户会话轮数上限
水位告警的触发方式是明确的“超过即告警”,适合守住已知的红线。缺点是它对“从没发生过的新问题”无能为力。
3.2 基于基线的动态异常检测
第二层解决的是“正常值本身在漂移”的问题。做法是基于历史数据建立基线,再对当前值做偏离判定:
- 同期基线:取过去 4 周同一星期、同一小时的用量中位数(P50),并计算 P95 分位
- 偏离判定:当前窗口用量超过基线 P95 的 N 倍(N 通常取 2~3),或连续 3 个统计窗口呈单调上升趋势
- 季节性分解:对工作日 / 周末、白天 / 深夜分别建基线,避免把正常的业务波峰误判为异常
- 突发检测:滑动窗口内的一阶差分超过阈值,用于捕捉秒级的请求尖峰
两类机制要同时开:静态阈值管已知边界,动态基线管未知漂移。
3.3 两个典型排错场景
场景一:客户端重试风暴
现象:某业务线 QPS 在短时间内明显上涨,但 Token 消耗涨幅不匹配,成功率反而下降。
下钻到日志层,retry_count > 0 的记录占比明显升高,同时 upstream_latency_ms 集中在超时阈值附近——这是典型的超时触发无退避重试。客户端 SDK 在默认配置下可能多次重试,叠加并发后请求量被放大,而上游实际只成功处理了其中一部分。
处置方式:服务端侧对该 Key 做速率熔断,客户端侧强制接入指数退避 + 抖动(jitter),并在网关侧对相同 prompt_hash 的短时间重复请求做去重合并。
场景二:Token 泄漏与死循环调用
现象:某个 API Key 在非业务时段持续产生调用,请求间隔高度均匀,单次 prompt_tokens 与 completion_tokens 稳定在较低水平。
基线检测报出的不是“量级异常”,而是分布异常——该时间段该 Key 的历史调用量接近零。进一步看,user_id 字段为空,来源 IP 不在企业出口白名单内。
结论:Key 被硬编码在前端包体或公开仓库中,被脚本持续薅用。处置路径很清晰:立即吊销 Key、轮换凭证、对该租户启用来源 IP 白名单、并在网关侧增加“匿名调用额度”兜底。
死循环则是另一种形态:Agent 类应用在工具调用失败时未设置最大轮次,导致单次用户请求在内部递归多轮,request_id 相同但内部轮次数发散。这类问题的表征是单会话 Token 消耗呈指数增长,靠总量告警很难及时捕捉,必须依赖单会话维度的基线检测。
四、成本预测与降本优化:把计量数据变成决策依据
前三层解决“看见”和“管住”,第四层解决“省下”。
4.1 用量预测与预算滚动
基于近 30~90 天的时序数据做预测(Holt-Winters 或 Prophet 等方案均可),输出未来 4~8 周的用量区间与置信带。用途有三个:
- 预算编制:把财务侧的年度预算分解到季度、月度,避免“年底突击花预算”
- 容量预留:对包年包月类资源做提前规划,避免临时按量计费的高单价
- 异常校准:预测值与实际值的偏离本身就是一种告警信号
4.2 模型替换模拟
这是被低估的一项能力。给定一批历史 Prompt 样本,把“当前模型 A”替换为“候选模型 B”,代入 B 的计费口径与预估的平均 Token 变化,直接算出成本差额与质量差异的权衡曲线。
模拟时至少要覆盖三个变量:计费口径差、Token 长度差(不同模型对同一 Prompt 的输出长度可能不同)、重试率差(输出不合格导致的二次调用)。只比单一计费口径不比总消耗,是最常见的误判来源。
4.3 优化思路示例:智能客服场景的分层与缓存
某智能客服系统在治理前,先按租户、模型、路径和缓存命中情况把用量拆开,再设计两类改造动作:
动作一:分层路由。 用轻量模型承接意图分类、FAQ 直出与结构化信息抽取,命中部分走轻量路径;剩余复杂问询才进入旗舰模型。
动作二:前缀缓存。 对旗舰模型路径启用 Prompt Cache,把系统提示与产品手册等长前缀固定下来,并按平台规则核算缓存命中部分。
改造后的效果应结合自身账单、路由命中率、缓存命中率和质量指标持续监控;本文不展开具体价格与金额对比。更重要的是,优化后的路由命中率、缓存命中率、各路径的单位调用成本,全部沉淀在看板与日志里,可以持续监控并逐月迭代。降本从“一次项目”变成了“一个可运营的指标”。
结语:先把计量做对,再把成本降下来
三种接入方式的成本治理对比,最终比的不是谁的单价低,而是谁能把成本拆解到可执行的最小单元。厂商直连给你的是账单,自建网关给你的是自由但更重的账单,托管中转平台给你的是口径统一、可下钻、可导出、可告警的完整计量链路。
如果你的团队正在做这几件事中的任意一件——多厂商模型混用、按业务线分摊成本、给客户做用量计费、或者单纯想把月度 Token 支出砍下一截——建议从第一步开始:打开计量看板,把过去 30 天的用量按租户和模型下钻一遍。多数情况下,你会在这个动作里发现至少两个此前完全没意识到的成本来源。
【非线智能API】提供统一的多模型接入、用量下钻分析、结构化调用日志与基线告警能力,支持 OpenAI 协议迁移与数据导出。团队可用小流量 Key 接入验证,把账本核对清楚——成本和风险,都会比预想的更清楚。