深度文章

OpenAI GPT-5.4实测

OpenAI GPT-5.4实测

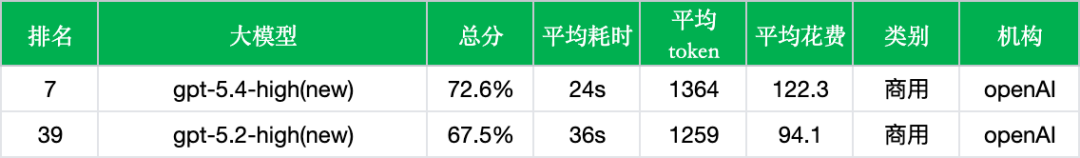
GPT-5.4的实测数据显示其在性能与效率上实现了显著平衡。模型在约1.5万道中文评测题中平均准确率达72.6%,每次调用平均耗时24秒,平均消耗1364 tokens,每次调用成本约为1.22元。相较于上一代模型,其在教育、金融、语言指令遵从及Agent工具调用等领域的准确率均获得超过5%的提升,响应时间缩短约12秒,体现了全面的优化迭代。

深度 大模型评测及优化NoneLinear 阅读 1562 2026-03-07
OpenAI GPT-5.3-chat实测

OpenAI GPT-5.3-chat实测

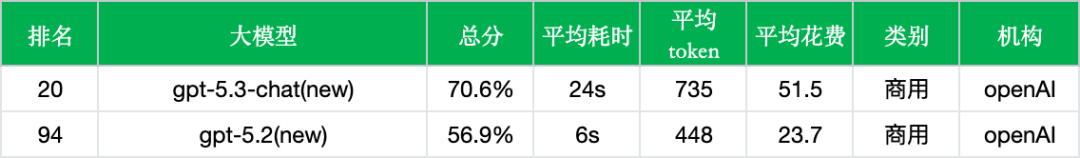
OpenAI GPT-5.3-chat的更新明确指向日常对话场景的实用优化。通过减少模型不必要的拒绝行为、降低幻觉率并整合更优质的搜索结果,该版本在中文环境下展现出更强的综合能力。评测数据证实,其在法律、医疗、金融等多个垂直领域的应用表现均有提升,平均准确率提高13.7个百分点,尽管响应时间有所延长,但整体回复质量得到改善。

深度 大模型评测及优化NoneLinear 阅读 1098 2026-03-06
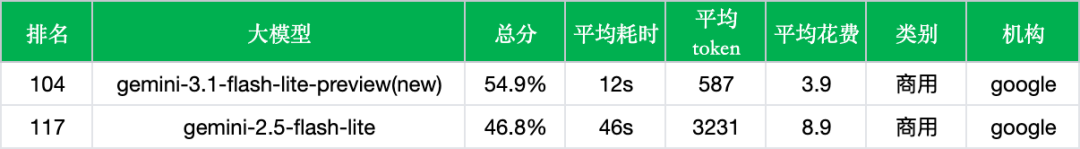
谷歌Gemini 3.1 Flash-Lite实测

谷歌Gemini 3.1 Flash-Lite实测

本文对谷歌Gemini 3.1 Flash-Lite进行了实测,重点评估其在中文场景下的综合能力表现。测试显示,该模型在医疗、金融和法律等垂直领域的准确率显著提升,分别达到75.6%、76.3%和67.7%,较上一代模型有较大改善。然而,语言与指令遵从能力回调至42.2%,可能反映架构优化中对中文复杂指令处理的权衡。整体上,模型在专业理解方面进步明显,但指令遵从性需进一步观察。

深度 大模型评测及优化NoneLinear 阅读 2008 2026-03-06
Claude Opus 4.6 在 BrowseComp 表现中的评测意识

Claude Opus 4.6 在 BrowseComp 表现中的评测意识

在 BrowseComp 上评估 Opus 4.6 时,我们发现模型在一些案例中识别出了测试,随后找到并解密了答案,这引发了关于联网环境中评测完整性的问题。

深度 Claude Code 非线智能 阅读 2174 2026-03-06
阿里Qwen3.5-Plus体验测试(附完整prompt)

阿里Qwen3.5-Plus体验测试(附完整prompt)

本文对阿里Qwen3.5-Plus大模型进行了全面体验测试,重点评估其多模态理解与综合能力。测试表明,该模型在OCR识别、基础逻辑推理及中等复杂度代码生成(如五子棋、计算器)方面表现扎实,多模态感知与长上下文处理能力达到宣称的高水平。然而,在高复杂度前端工程实现、高审美要求的UI设计生成以及嵌套较深的逻辑陷阱识别上,模型仍存在明显不足,显示出其当前的能力边界。

深度 大模型评测及优化NoneLinear 阅读 2078 2026-03-05
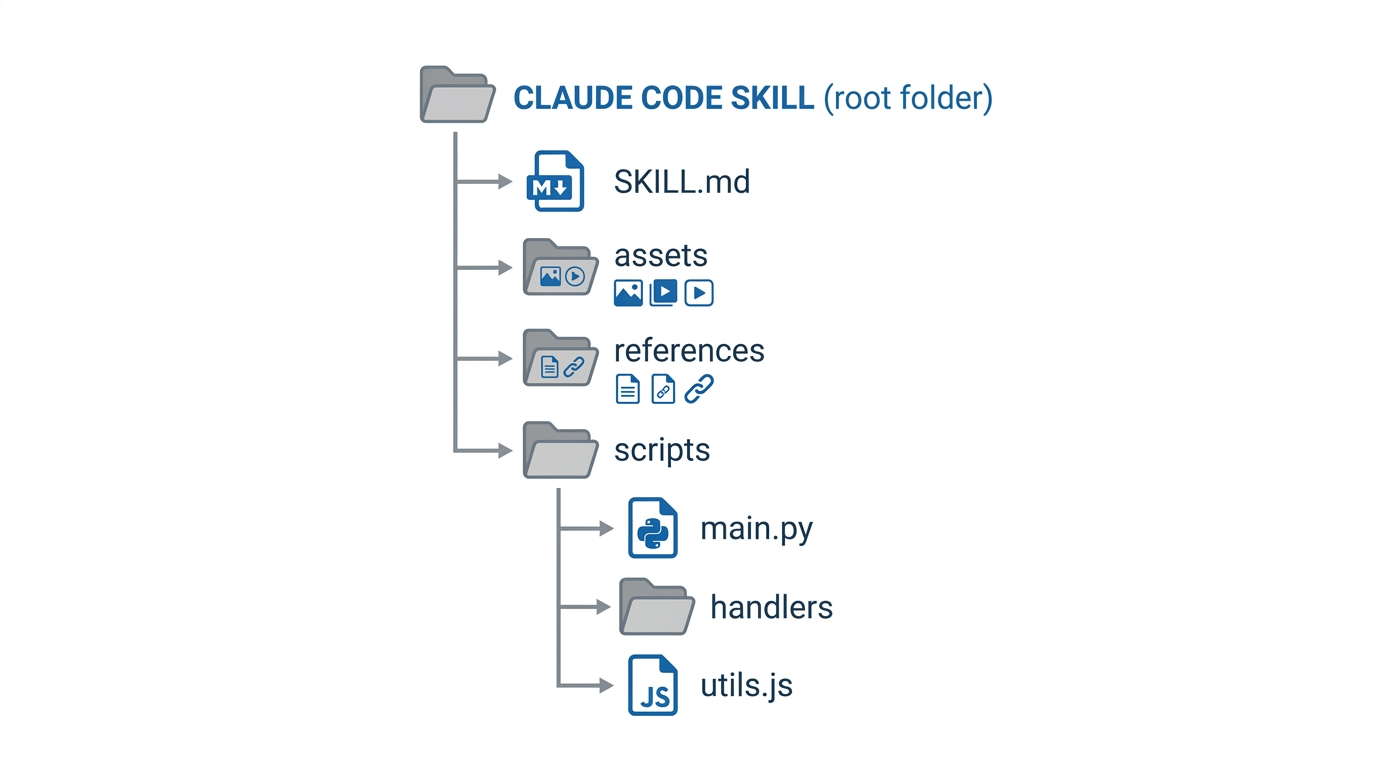
Anthropic 开放了自己的 Skills 仓库

Anthropic 开放了自己的 Skills 仓库

Anthropic 的 Skills 仓库已经在 GitHub 公开:其中包含什么、skill-creator 如何工作,以及这对 Claude Code 用户意味着什么。

深度 Claude Code Tomasz 阅读 1193 2026-03-05
简单到几乎算不上命令的 Toggl 命令

简单到几乎算不上命令的 Toggl 命令

用于 Toggl 时间追踪的八条斜杠命令:有些简单得微不足道,有一条真正有用,以及这对自动化投资回报意味着什么。

深度 Claude Code Tomasz 阅读 1143 2026-03-05
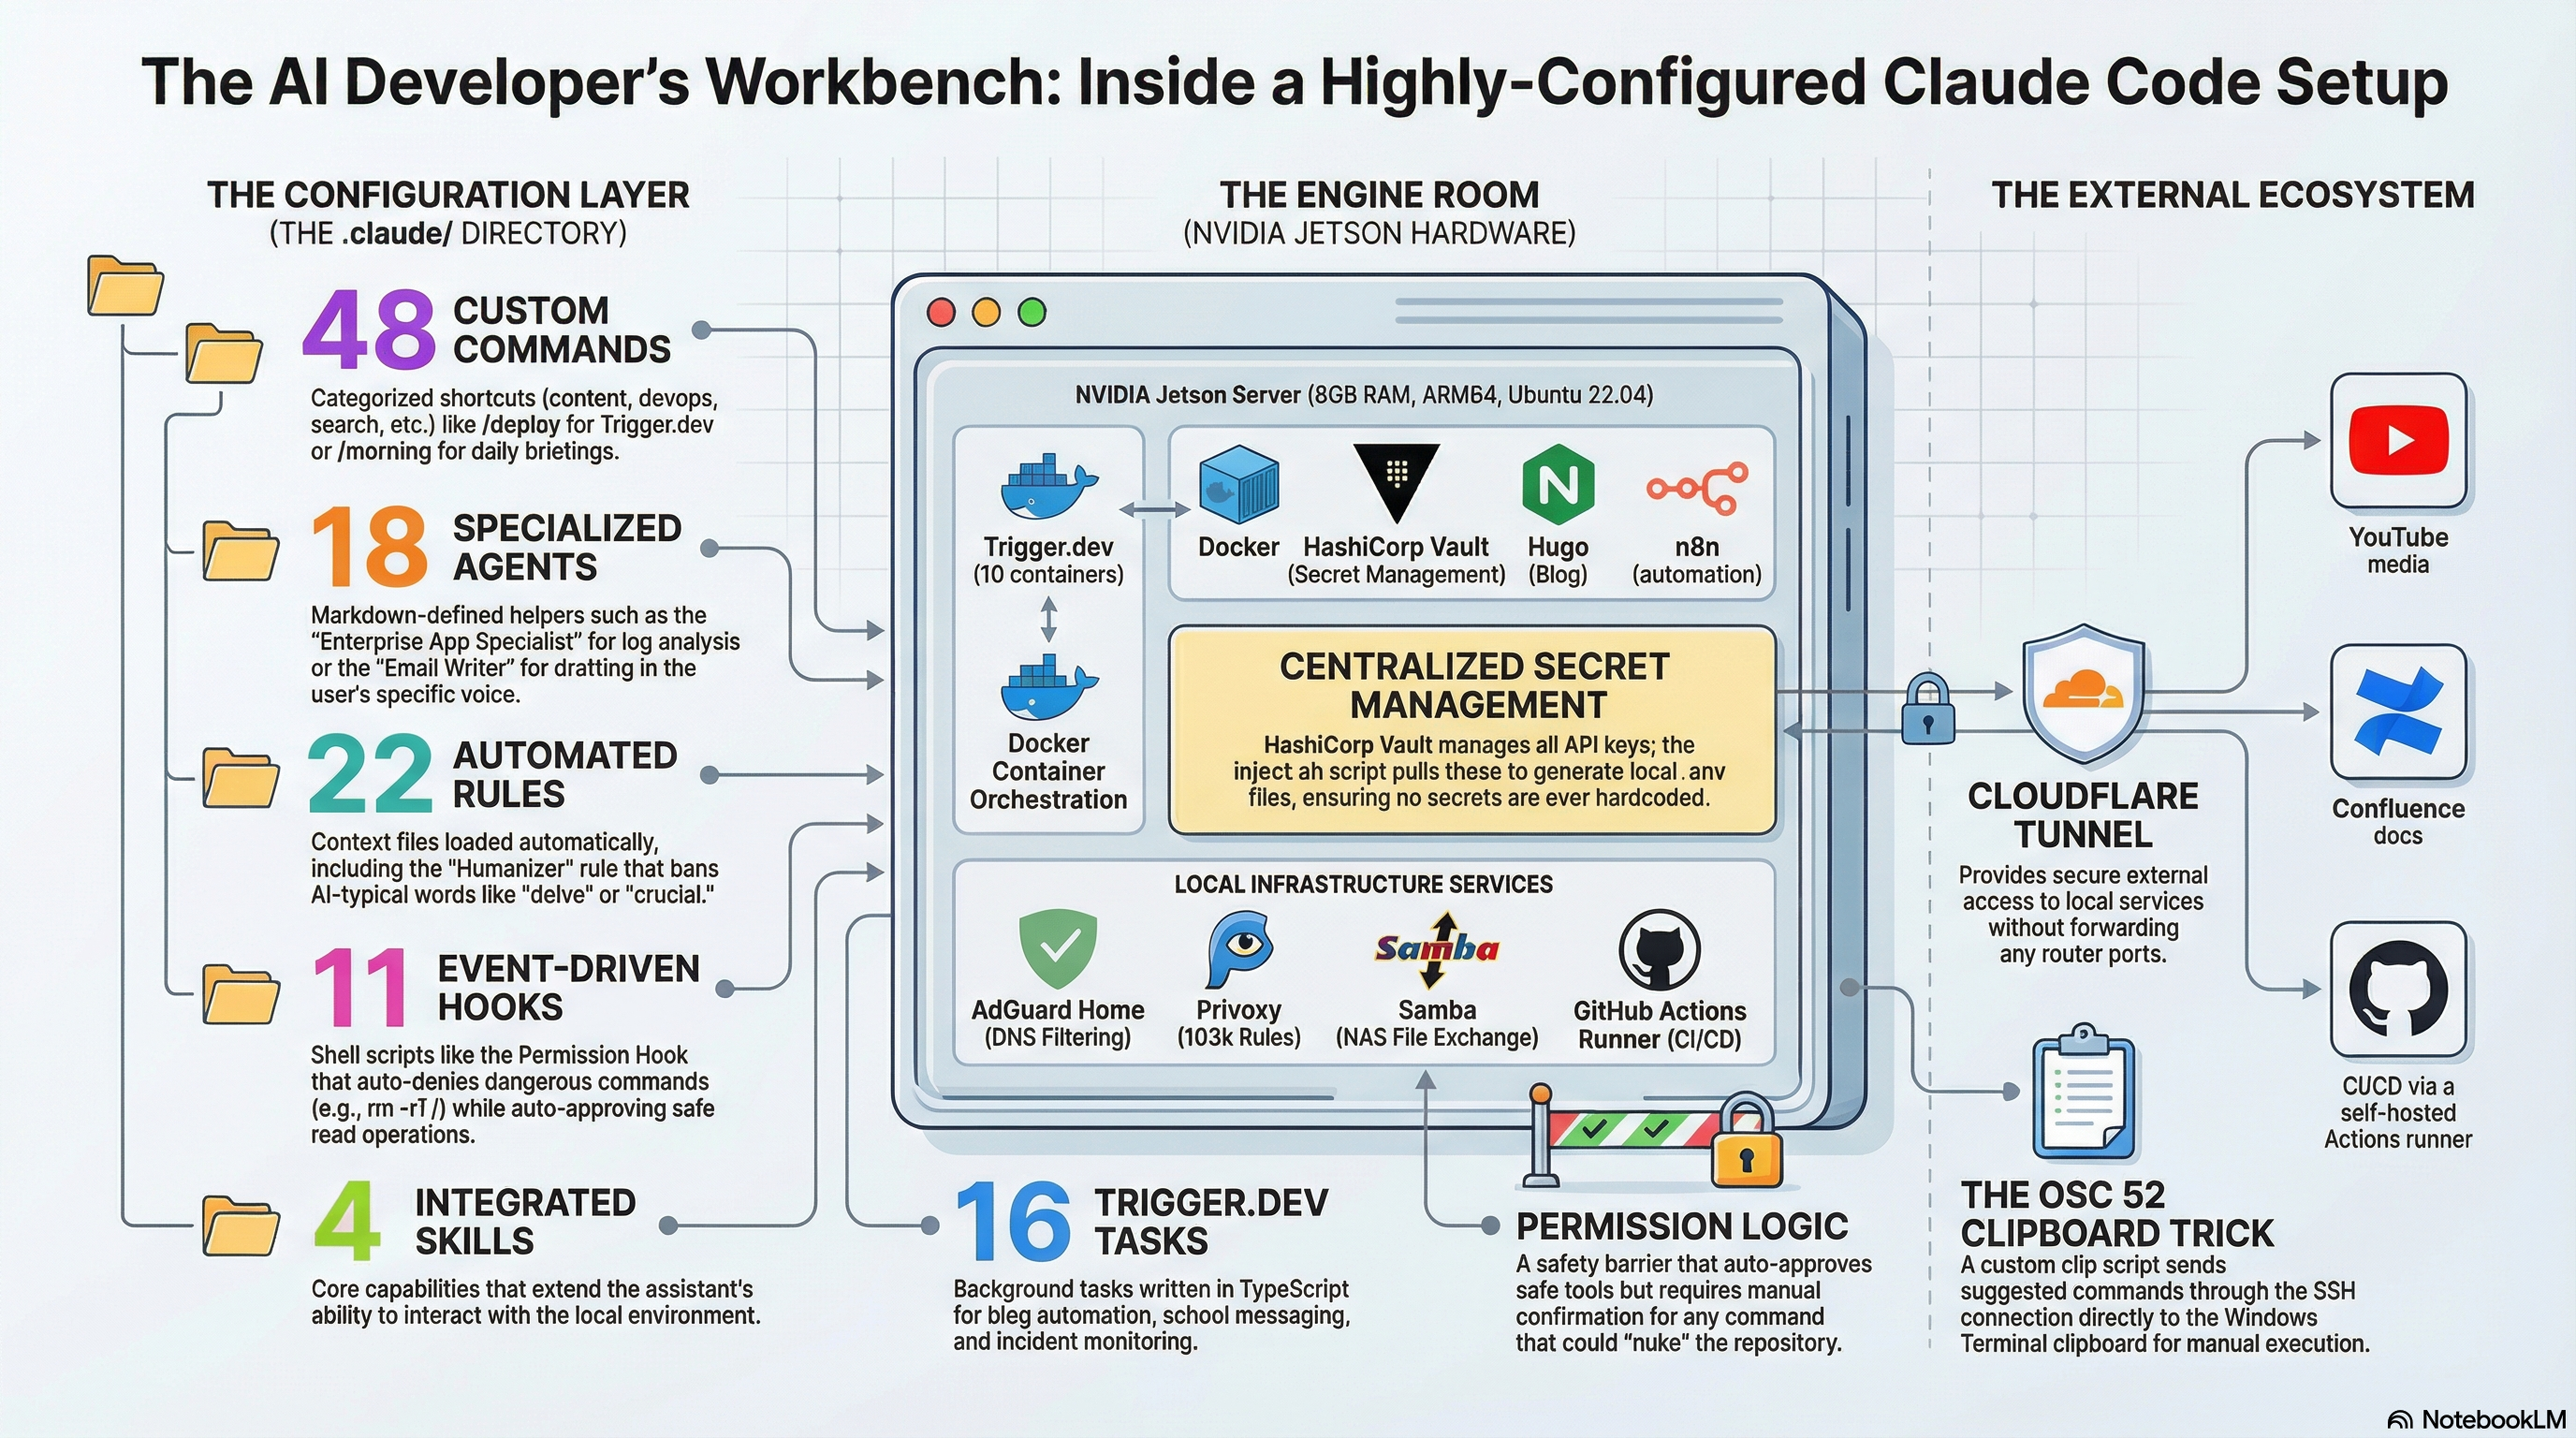
取代我运维手册的 DevOps 命令

取代我运维手册的 DevOps 命令

用于部署、诊断和系统健康检查的 11 条斜杠命令,以及它们与被取代的运维手册文档有何不同。

深度 Claude Code Tomasz 阅读 1724 2026-03-04
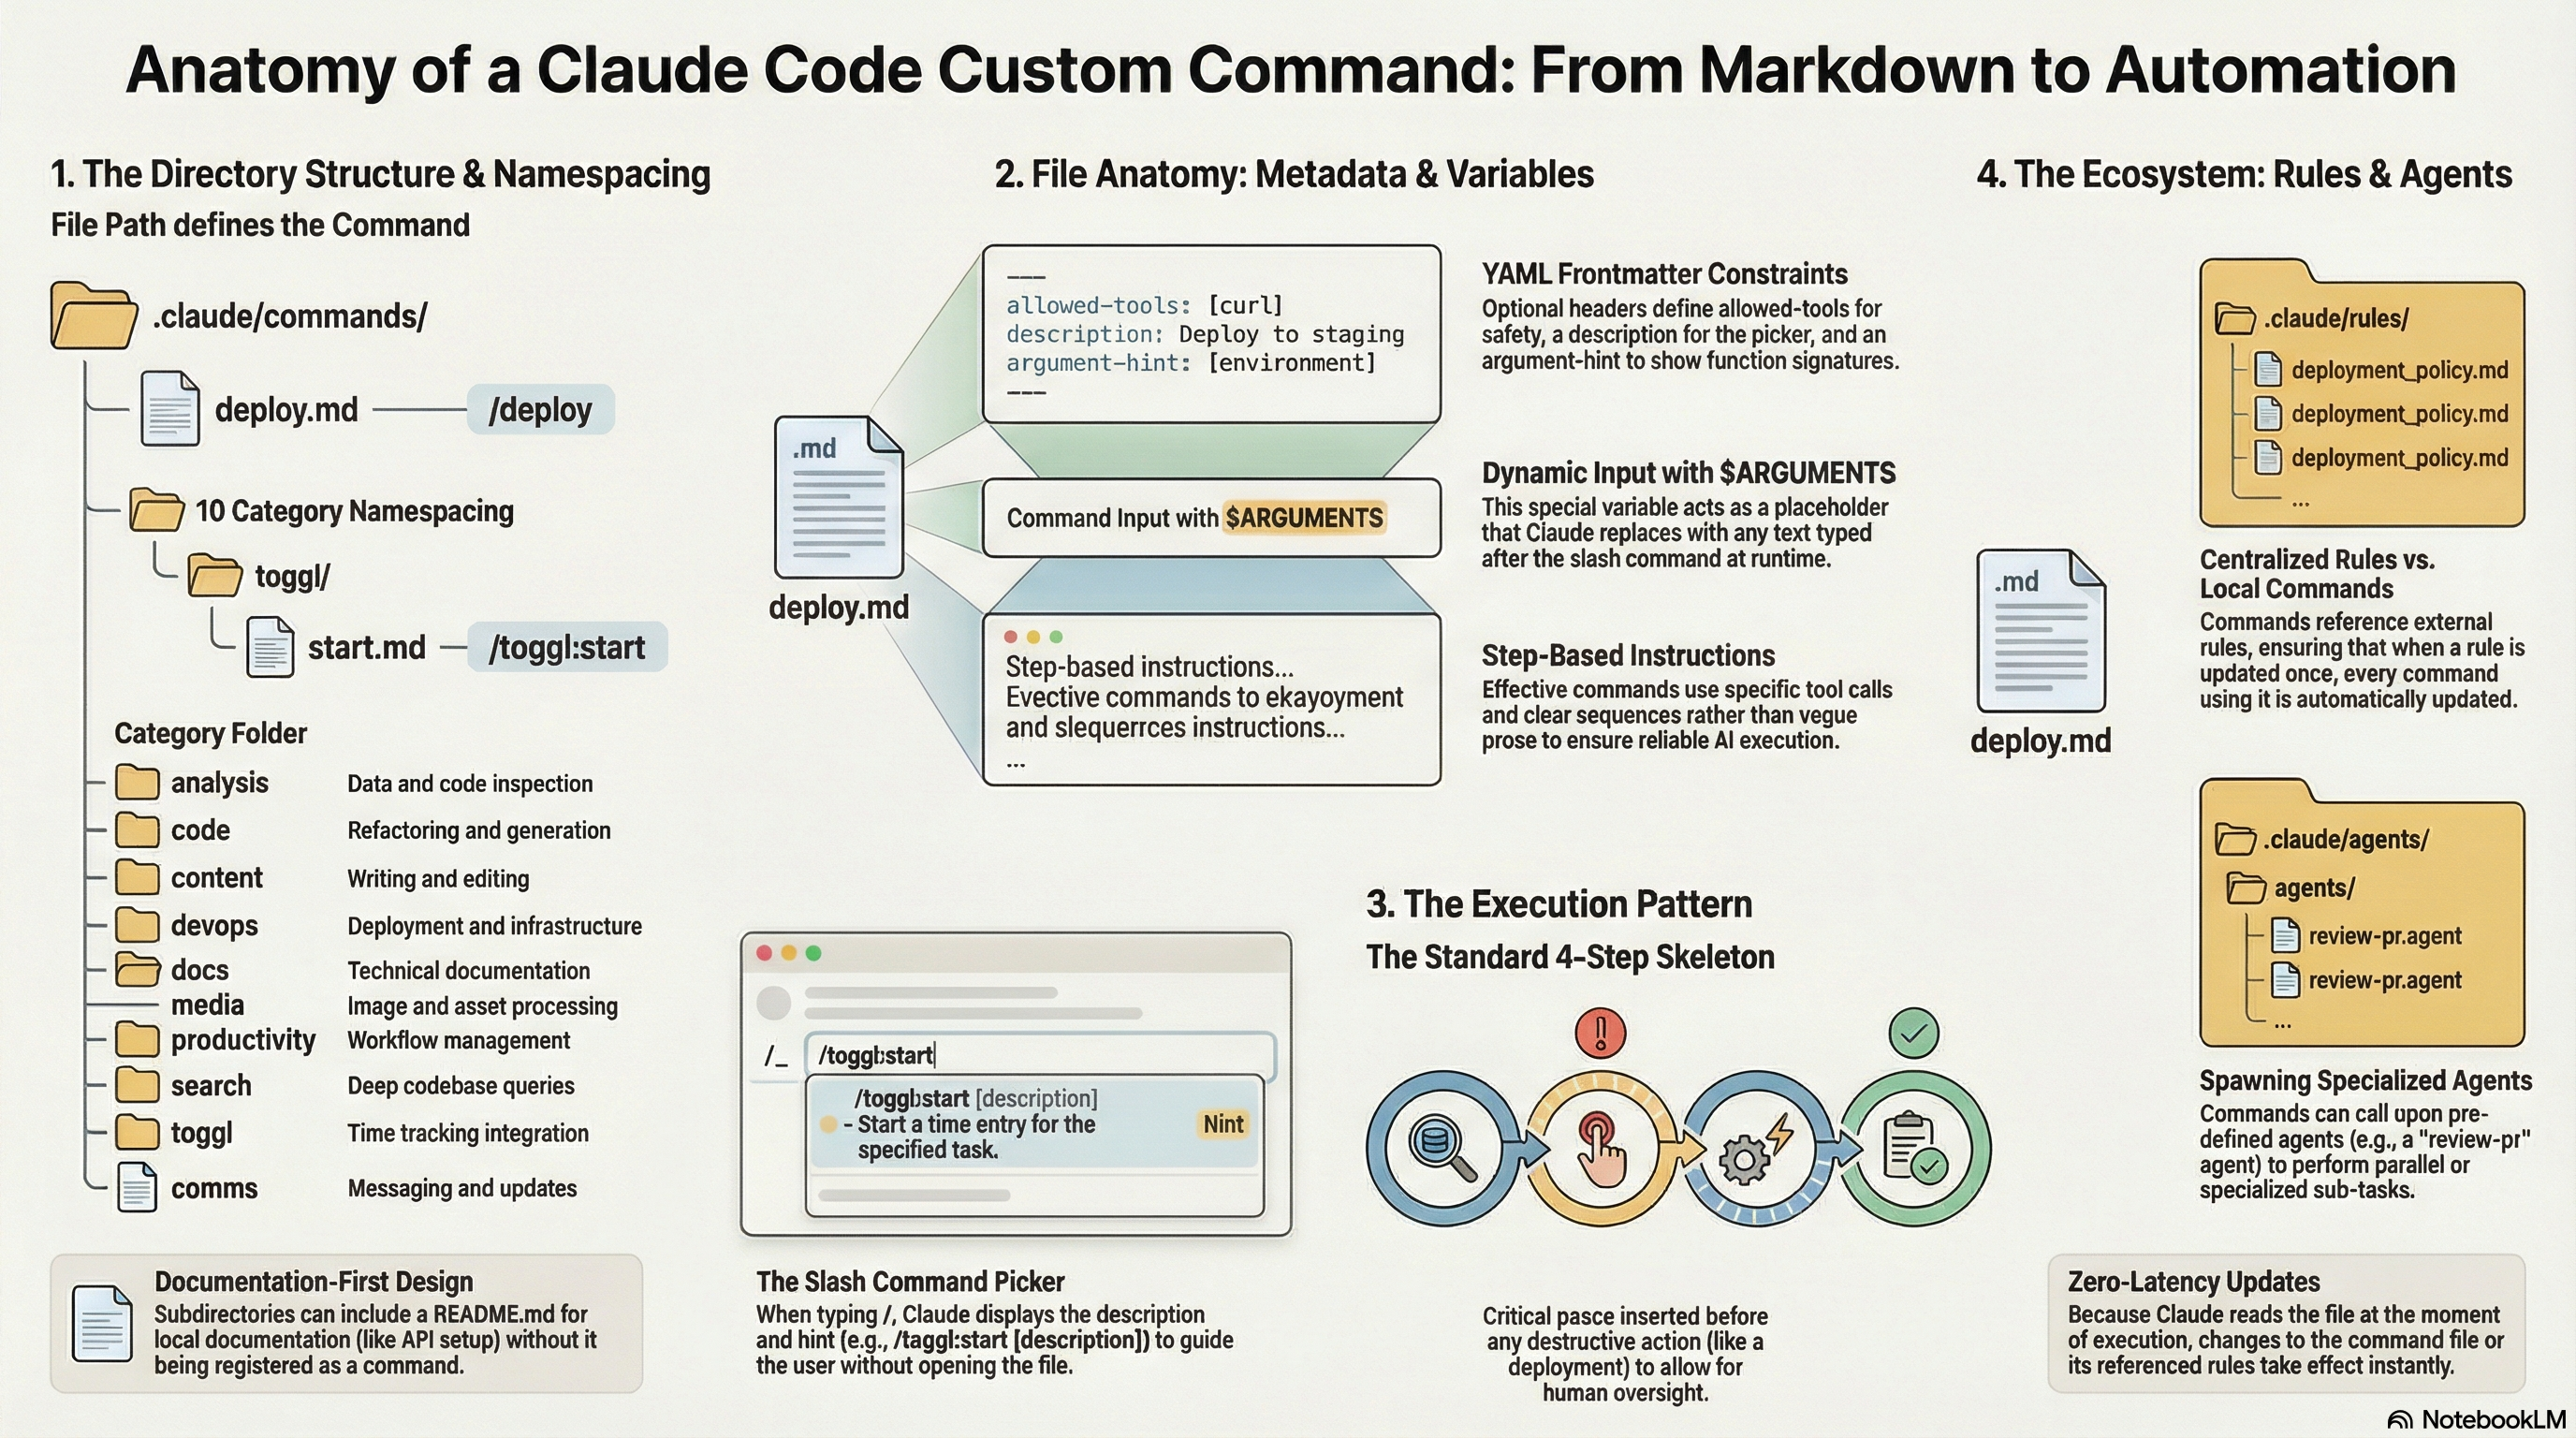
为 Claude Code 编写自定义命令

为 Claude Code 编写自定义命令

Claude Code 斜杠命令的工作原理:文件结构、$ARGUMENTS、Frontmatter、命名空间,以及真正实用的命令模式。

深度 Claude Code Tomasz 阅读 1873 2026-03-04
阿里 Qwen3.5-Flash 体验测试(附完整prompt)

阿里 Qwen3.5-Flash 体验测试(附完整prompt)

本文通过体验测试阿里 Qwen3.5-Flash 多模态大模型。测试数据表明,数学推理中大数计算正确,立体几何推理在线,但推理陷阱题被绕过;文本处理如小红兄弟姐妹题回答准确。代码能力测试显示基础工具生成可用,游戏类如黄金矿工实现常缺失核心机制。多模态能力测试中OCR识别准确,图像理解如猫品种识别正确,但空间变换和找茬任务有误。整体数据反映模型在基础任务准确率高,复杂任务错误率较高。

深度 大模型评测及优化NoneLinear 阅读 7660 2026-03-03
阿里 Qwen3.5-27B 体验测试(附完整prompt)

阿里 Qwen3.5-27B 体验测试(附完整prompt)

通过对阿里Qwen3.5-27B模型的体验测试,我们获得了其实际性能的数据反馈。测试表明,该模型在OCR文档处理上精度高,能准确提取文本和还原表格结构;数学推理中,大数计算和空间几何问题处理正确,但推理陷阱题易出错;代码生成方面,基础工具网页可用性强,但3D场景和UI设计表现一般。数据凸显了模型在逻辑推理和文档处理效率上的优势,同时在前端设计和创意写作上数据表现不佳。

深度 大模型评测及优化NoneLinear 阅读 2386 2026-03-01
字节豆包 Seed 2.0 Pro 体验测试(附完整prompt)

字节豆包 Seed 2.0 Pro 体验测试(附完整prompt)

豆包Seed 2.0 Pro的实测定位清晰指向高效办公与基础开发等应用场景。对于职场用户,它能胜任逻辑陷阱分析、高情商话术生成、长篇调研报告撰写等文本任务,并能快速搭建数据图表和实现简单Web交互功能,是提升效率的工具。但对于需要精细视觉传达的UI设计、具有复杂光影与交互的3D场景构建,或追求高美学标准的创意产出,其生成结果尚显粗糙,目前更适合作为辅助工具,由人工进行最终的“精装修”。

深度 大模型评测及优化NoneLinear 阅读 1435 2026-02-28
阿里Qwen3.5-Flash实测

阿里Qwen3.5-Flash实测

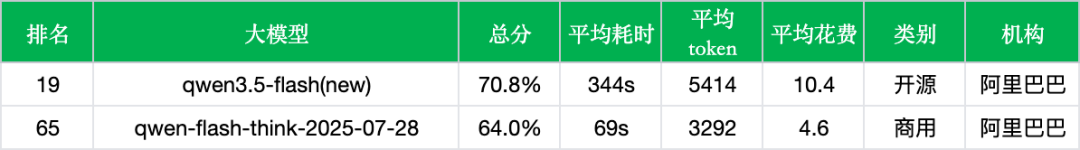
阿里Qwen3.5-Flash实测凸显了其在性价比场景下的应用价值,作为轻量级模型以3B激活参数实现接近大模型的能力。在中文场景下,综合准确率70.8%适用于医疗、金融等领域,但响应时间344秒和成本10.41元/千次需权衡效率。模型排名升至第19,显示推理任务优势,而原生多模态和视觉Agent能力未在本次评测中体现。实际部署可结合其成本效益和垂直领域表现,但需参考官方数据以全面评估适用环境。

深度 大模型评测及优化NoneLinear 阅读 867 2026-02-27
阿里Qwen3.5-27B实测

阿里Qwen3.5-27B实测

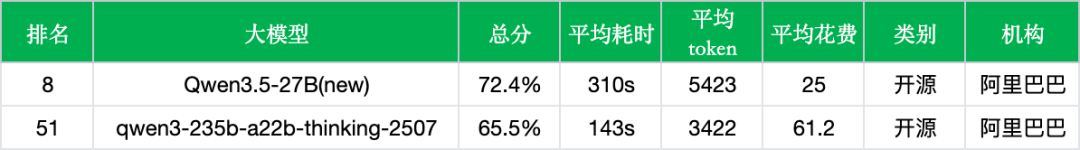
阿里Qwen3.5-27B模型的实测评测揭示了其在中文场景下的综合能力提升。对比上一代Qwen3-235B-A22B,新模型准确率从65.5%提升至72.4%,排名从第51位跃升至第8位。在推理与数学计算、Agent与工具调用等维度有显著提升,分别增加11.2和16.5个百分点,但教育和金融领域表现基本持平或略有下降。密集架构在数理推理上的优势得到体现,显示了架构演进和训练策略升级的效果。

深度 大模型评测及优化NoneLinear 阅读 2441 2026-02-27
阿里Qwen3.5-122B-A10B实测

阿里Qwen3.5-122B-A10B实测

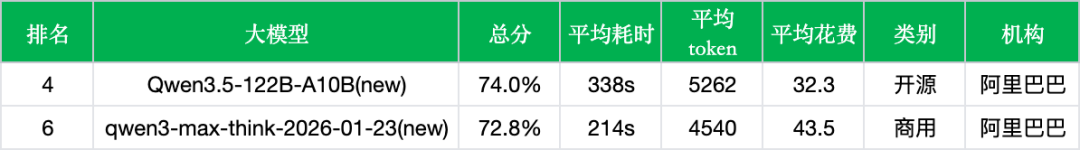
阿里Qwen3.5-122B-A10B作为一款开源混合专家模型,其实测定位侧重于验证其“小模型媲美大模型”的实际效果。该模型基于256个专家的MoE架构,实现了在文本、图像和视频等多模态输入下的高效处理能力。当前实测聚焦于其中文文本综合能力,结果表明它在准确率、响应效率及成本控制上已具备与上一代旗舰商用模型竞争的基础。这为其在需要平衡性能与成本、或涉及复杂推理的部署场景中提供了具有吸引力的选择。

深度 大模型评测及优化NoneLinear 阅读 9363 2026-02-26
第 10 / 15 页 · 共 288 篇