深度文章

GPT-5.1-high实测

GPT-5.1-high实测

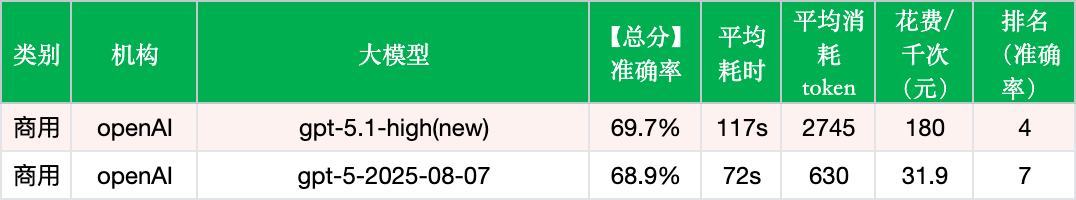
GPT-5.1-high实测深入分析了该模型的性能变化。测试结果显示,整体准确率从68.9%微增至69.7%,但推理与数学计算能力显著提升10.0个百分点,达到84.7%。医疗、金融和法律等专业领域准确率也有小幅改善。然而,语言理解能力下滑8.6%,教育领域下降2.5%,表明深度思考模式在增强推理的同时削弱了基础指令遵从。模型平均耗时117秒,token消耗激增336%,反映了高性能的代价。

深度 大模型评测及优化NoneLinear 阅读 1243 2025-11-27
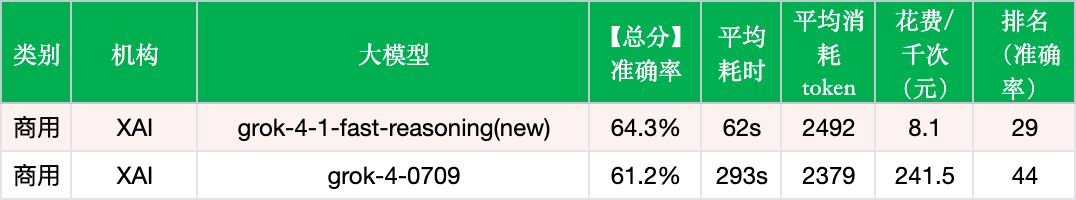
Grok-4-1-fast-reasoning实测

Grok-4-1-fast-reasoning实测

Grok-4-1-fast-reasoning的实测聚焦于其在智能体工具调用场景下的优化效果。官方定位为高性能智能体模型,Agent能力从48.4%提升至65.4%,速度从293秒缩短至62秒,显著改善响应体验,成本从每千次241.5元降至8.1元。然而,在实际应用中,准确率64.3%在同成本模型中表现中等,且专业领域能力下滑,可能限制多场景适用性,需在速度与准确率间权衡。

深度 大模型评测及优化NoneLinear 阅读 2943 2025-11-26
Grok-4-1-fast-non-reasoning实测

Grok-4-1-fast-non-reasoning实测

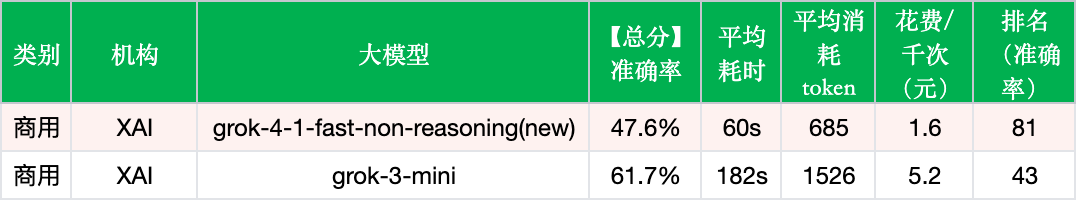
本文对Grok-4-1-fast-non-reasoning模型进行了数据驱动的实测。测试基于约1.5万道题,准确率为47.6%,平均响应时间60秒,每次调用消耗685 token,成本为每千次调用1.61元。对比前代grok-3-mini,准确率从61.7%骤降至47.6%,降幅14.1个百分点;响应时间从182秒缩短至60秒,提速67%;token消耗减少,导致成本从5.2元降至1.6元。

深度 大模型评测及优化NoneLinear 阅读 3545 2025-11-26
长时间运行智能体的有效运行框架

长时间运行智能体的有效运行框架

智能体在跨越多个上下文窗口工作时仍面临挑战。我们从人类工程师身上获得启发,为长时间运行的智能体创建更有效的运行框架。

深度 Claude Code 非线智能 阅读 1303 2025-11-26
Gemini-3-pro 实测:登顶榜首但成本激增,打破豆包250天霸榜神话

Gemini-3-pro 实测:登顶榜首但成本激增,打破豆包250天霸榜神话

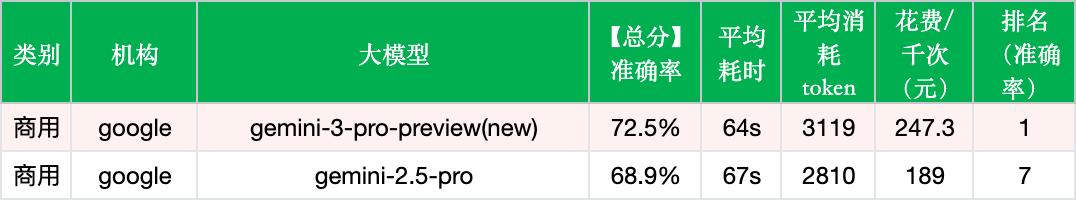
Gemini-3-pro-preview虽在评测中超越豆包成为新王者,但高成本可能严重限制其商用场景应用。每千次调用247.3元的成本是豆包的近16倍,对于日常应用如客服或内容生成,规模化部署面临显著障碍。尽管响应时间优化至64秒,但豆包的37秒在实时交互中更具优势,影响用户体验。在科研或极致准确率需求领域成本或许可接受,但普遍商用需权衡性能与费用,其医疗和推理领域优势与语言理解回退共同影响通用性

深度 大模型评测及优化NoneLinear 阅读 2748 2025-11-25
Claude Code 斜杠命令完全指南(2026)

Claude Code 斜杠命令完全指南(2026)

使用斜杠命令把 Claude Code 从聊天机器人改造成确定性执行引擎,并通过完整工作流自动完成整个功能开发周期。

深度 Claude Code Alexander Opalic 阅读 2624 2025-11-22
GPT-5.1-medium实测

GPT-5.1-medium实测

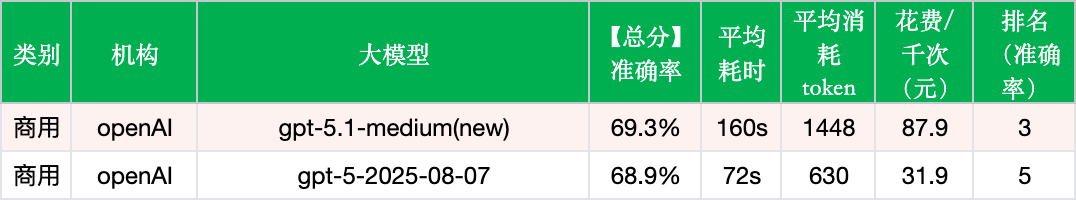
GPT-5.1-medium实测评估了其在多个实际应用场景中的表现。医疗与心理健康领域准确率从75.6%升至77.3%,金融领域从71.3%升至75.4%,agent与工具调用从57.8%升至61.7%,显示在专业任务中能力强化。思考模式适合需要深度推理的复杂场景,但教育和法律行政领域下降,且高token消耗和响应时间可能限制日常应用。

深度 大模型评测及优化NoneLinear 阅读 2435 2025-11-21
GPT-5.1实测:准确率大幅下滑,OpenAI押注"情绪价值"能否奏效?

GPT-5.1实测:准确率大幅下滑,OpenAI押注"情绪价值"能否奏效?

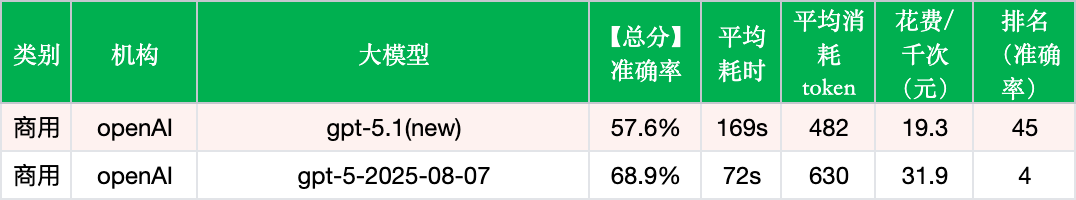
GPT-5.1的战略转型意味着其应用场景的定位可能发生变化。模型在传统基准任务上的性能退步,表明它或许不再以复杂的专业分析、精确的数学推理或严格的指令执行见长。相反,官方强调的“更温暖、更有同理心”的特性,暗示其更适用于注重交互流畅性、情感陪伴和自然对话的场景。因此,对于需要高度精确性和逻辑深度的应用,该版本可能并非最优选择,而在强调沟通体验的领域,其潜在价值有待进一步评估。

深度 大模型评测及优化NoneLinear 阅读 3221 2025-11-20
Gemini 3 Pro体验测试:当AI真的开始"思考",会发生什么?(附体验链接)

Gemini 3 Pro体验测试:当AI真的开始"思考",会发生什么?(附体验链接)

谷歌Gemini 3 Pro作为全球最强多模态推理模型,展示了AI在复杂任务中的推理与执行能力。测试覆盖学习辅助、创意开发、代码生成和长期规划四个场景,要求生成可直接运行的代码或可交付成果。模型能够处理多模态输入,输出符合技术要求的HTML、React应用或策略报告,体现其将抽象需求转化为具体功能的能力,标志着AI在思考与实践结合上的进步。

深度 大模型评测及优化NoneLinear 阅读 1689 2025-11-19
MiniMax-M2实测:轻量级MoE架构带来性能提升与成本优化

MiniMax-M2实测:轻量级MoE架构带来性能提升与成本优化

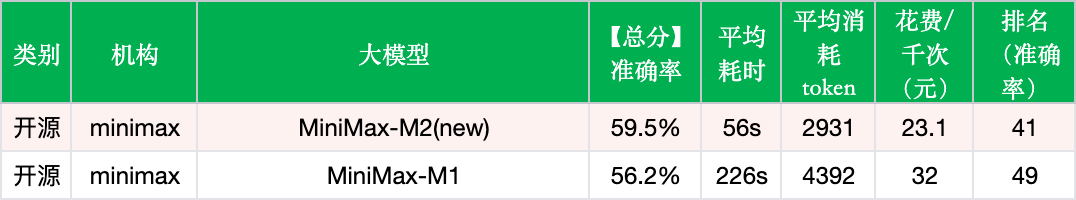
MiniMax-M2是一款专为编码与智能体应用设计的轻量级MoE模型,其轻量架构在多个能力维度实现了性能与效率的权衡。新版本在保持推理能力稳定的同时,显著优化了语言指令遵从及工具调用能力,准确率提升3.3个百分点。不过在部分专业领域的表现有所回落,体现了针对通用场景的优化侧重。

深度 大模型评测及优化NoneLinear 阅读 1799 2025-11-04
通过 MCP 执行代码:构建更高效的智能体

通过 MCP 执行代码:构建更高效的智能体

直接工具调用会为每个定义和结果消耗上下文。让智能体编写代码来调用工具,扩展性会更好。下面介绍它如何与 MCP 配合工作。

深度 Claude Code 非线智能 阅读 907 2025-11-04
超越权限提示:让 Claude Code 更安全、更自主

超越权限提示:让 Claude Code 更安全、更自主

Claude Code 新增的两项沙箱功能:沙箱化 bash 工具和网页版 Claude Code,通过启用文件系统与网络隔离这两道边界,减少权限提示并提升用户安全性。

深度 Claude Code 非线智能 阅读 1676 2025-10-20
AI 智能体的有效上下文工程

AI 智能体的有效上下文工程

上下文是 AI 智能体的一项关键但有限的资源。在本文中,我们探讨如何有效筛选和管理驱动智能体运作的上下文。

深度 Claude Code 非线智能 阅读 3249 2025-09-29
近期三个问题的事后复盘

近期三个问题的事后复盘

这是一份关于三个 bug 的技术报告,这些 bug 曾间歇性降低 Claude 的响应质量。下文会解释发生了什么、为什么修复花了时间,以及我们正在改变什么。

深度 Claude Code 非线智能 阅读 2469 2025-09-17
第 14 / 15 页 · 共 288 篇