
 正文:
本次 ReLE 评测侧重中文场景下的综合能力,涵盖教育、医疗、金融、法律、推理数学、语言指令、Agent 工具调用及 Coding 八个板块,相关官方基准数据我们统一放在“3、官方评测”中进行梳理。
deepseek-v4.1-flash版本表现:
- 测试题数:约1.5万
- 总分(准确率):74.4%
- 平均耗时(每次调用):26s
- 平均token(每次调用消耗的token):2761
- 平均花费(每千次调用的人民币花费):20.7
1、新旧对决
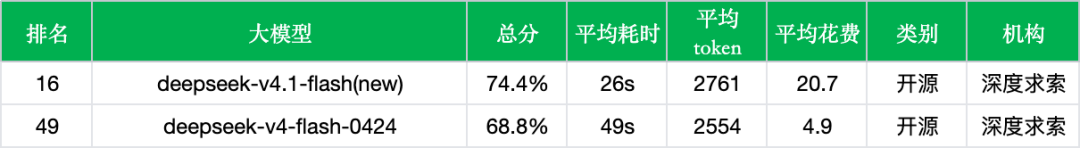
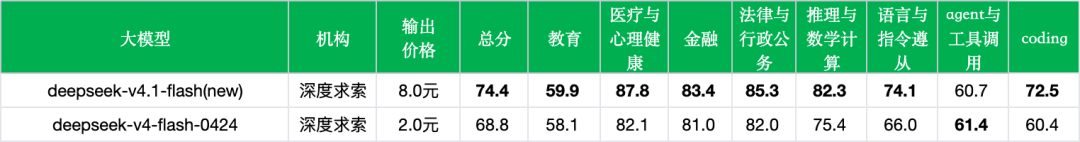
对比上一代参照模型 deepseek-v4-flash-0424,新版本在 ReLE 中文综合评测中的变化非常直观:综合准确率显著提升、榜单排名大幅跃升,响应速度近乎翻倍;但伴随而来的,是 Token 生成量与调用成本的明显增加。具体对比数据如下:
*数据来源:非线智能ReLE评测https://github.com/jeinlee1991/chinese-llm-benchmark
*输出价格单位: 元/百万token
- 总分和排名:deepseek-v4.1-flash 总分从 68.8% 提升至 74.4%(+5.6 个百分点),总榜排名从第 49 位跃升至第 16 位。对于一款主打 Flash 定位的轻量模型而言,成功冲入总榜前二十,提升幅度相当可观。
- Coding提升最大:Coding 准确率从 60.4% 跃升至 72.5%,大涨 12.1 个百分点,是本次迭代中进步最显著的板块,与官方主打代码工程任务的定位高度契合。
- 语言指令和推理数学明显上行:语言与指令遵循从 66.0% 提升到 74.1%(+8.1 个百分点),推理与数学计算从 75.4% 升至 82.3%(+6.9 个百分点)。这两门核心基础能力的强化,是带动总分跃升的关键支撑。
- 医疗、法律和金融继续补齐:医疗与心理健康从 82.1% 提至 87.8%(+5.7 个百分点),法律与行政公务从 82.0% 提至 85.3%(+3.3 个百分点),金融从 81.0% 提至 83.4%(+2.4 个百分点)。教育板块从 58.1% 升至 59.9%(+1.8 个百分点),增幅相对平稳。
- Agent工具调用小幅回调:Agent 与工具调用从 61.4% 微跌至 60.7%(-0.7 个百分点)。
- 响应速度改善:单次调用平均耗时从 49 秒缩短到 26 秒,耗时骤减 47%。在准确率大幅走高的同时,生成延迟却接近减半,这是实际业务落地中体感最显著的升级。
- Token与花费:平均单次 Token 消耗从 2554 增至 2761(+8.1%);输出价格从 2.0 元/百万token 上调至 8.0 元/百万token,千次调用成本从 4.9 元上升到 20.7 元(约为上一代的 4.2 倍)。
2、横向对比
放在当前主流大模型的竞争坐标系中,deepseek-v4.1-flash 究竟处于怎样的水平?我们分别从同成本档位、内部产品线梯队以及开源与商用生态三个维度进行对照:
*数据来源:非线智能ReLE评测https://github.com/jeinlee1991/chinese-llm-benchmark
同成本档位对比
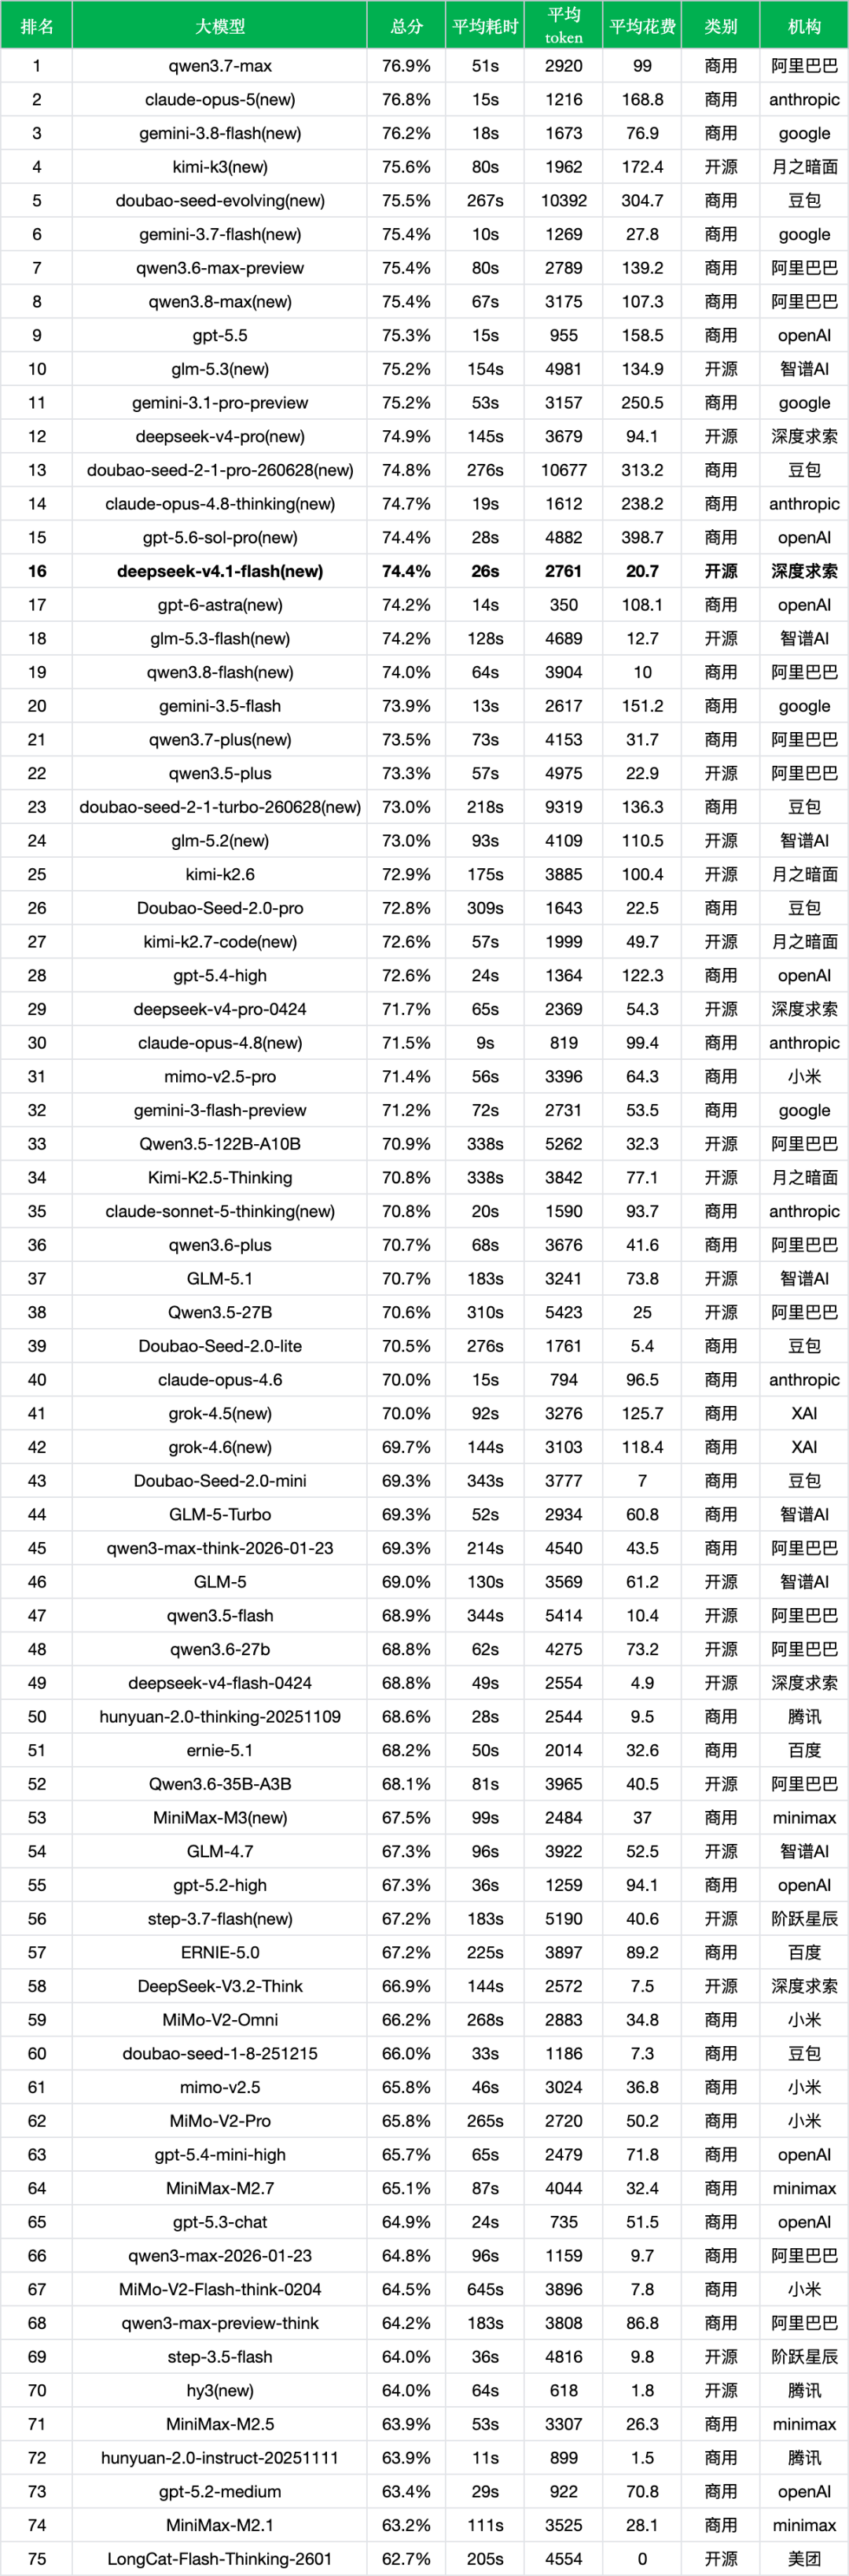
- 20元附近档位处在较高位置:在千次调用 20 元左右的价格区间内,deepseek-v4.1-flash(74.4%,20.7元)展现出了明显的准确率优势。同成本档位竞品中,qwen3.5-plus(73.3%,22.9元)、Doubao-Seed-2.0-pro(72.8%,22.5元)和 Qwen3.5-27B(70.6%,25元)的总分均低于它,成本效率比优势清晰。
- 与更低花费Flash模型接近:对比成本更低的 glm-5.3-flash(74.2%,12.7元)和 qwen3.8-flash(74.0%,10元),新 Flash 胜在综合准确率略高(高出 0.2~0.4 个百分点),但后两者的调用成本便宜近一半。对于预算极其敏感、需要超大规模跑批的业务,低价 Flash 依然是强劲备选。
- 响应速度处在中上:deepseek-v4.1-flash 平均耗时 26 秒,虽然落后于部分海外顶尖闭源模型(如 gemini-3.8-flash 18s、claude-opus-5 15s、gpt-6-astra 14s),但在开源阵营中极具竞争力,明显快于 qwen3.8-flash(64s)、qwen3.7-plus(73s)以及自家 deepseek-v4-pro(145s)、glm-5.3(154s)等,实用性大幅增强。
新旧模型对比
- Flash线从中游进入前列:上一代 deepseek-v4-flash-0424(68.8%)仅排在第 49 位,处在榜单中段;而 deepseek-v4.1-flash(74.4%)直接跨入第 16 名,一跃跻身前列。这主要归功于 Coding、指令遵循、数理推理及医疗领域的显著进步。
- 与DeepSeek Pro线差距缩小:当前旗舰 deepseek-v4-pro(74.9%,94.1元,第12位)与新 Flash(74.4%,20.7元,第16位)的总分仅相差 0.5 个百分点。新 Flash 不仅大幅超越了早期的 deepseek-v4-pro-0424(71.7%,54.3元)和 DeepSeek-V3.2-Think(66.9%,7.5元)。
- 产品线分工更清楚:新旧对比让内部定位更加明朗:新 Flash 承担起了“高成本效率比、低延迟、能打胜任大部分通用任务”的日常主力角色;而 Pro 旗舰则主攻少数超高难度的长尾复杂逻辑。日常问答、常规代码辅助及批量文本分析,Flash 已经具备极强的平替能力。
开源/商用对比
- 开源阵营中的相对位置:在 ReLE 收录的开源模型中,deepseek-v4.1-flash 仅落后于 kimi-k3(75.6%,172.4元)、glm-5.3(75.2%,134.9元)和自家 Pro(74.9%,94.1元),直接超越了上一代百元级旗舰 glm-5.2(73.0%,110.5元)与 kimi-k2.6(72.9%,100.4元)。作为一款轻量级 Flash,它已经跻身开源头部阵营。
- 与商用Flash模型互有取舍:海外头部模型如 gemini-3.8-flash(76.2%,76.9元)和 gemini-3.7-flash(75.4%,27.8元)在绝对分数上略高,但调用成本和生态不同;国内商用如 qwen3.8-flash(74.0%,10元)虽然分数稍逊,但更便宜。如果重视中文场景准确率与开源私有化的自主可控,新 Flash 表现均衡;若是超大规模的海量低预算任务,则极低单价的 Flash 竞品依然实用。
- 选型边界:deepseek-v4.1-flash 尤其适合对中文综合准确率、响应延迟有硬性要求,同时看重开源架构可控性的中高要求业务;如果业务只关注单价极致压低、对质量上限要求不高,老款 Flash 或其它超低价模型仍可按需选用。
3、官方评测
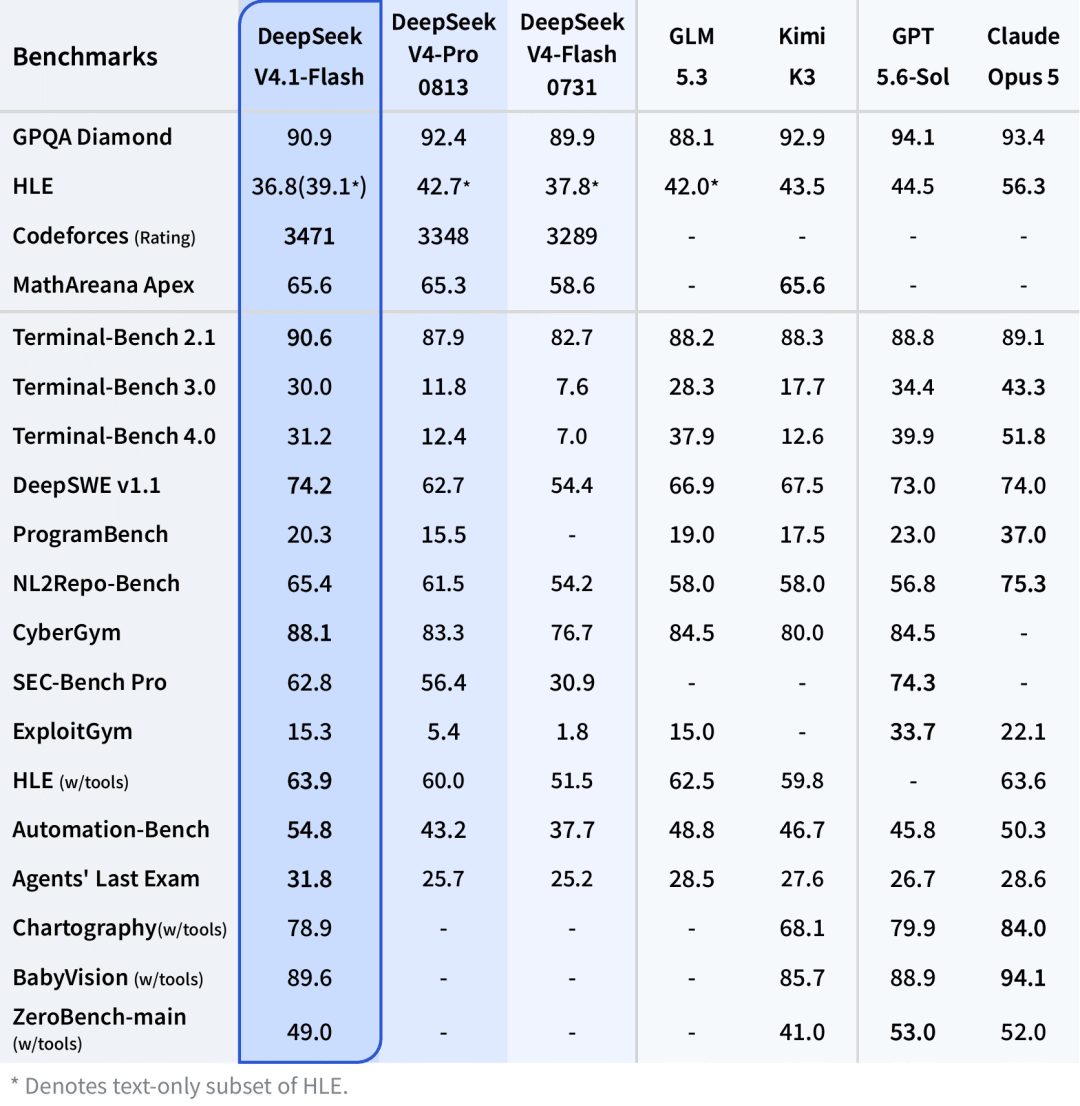
参考 DeepSeek 官方博客(https://www.deepseek.com/en/news/deepseek-v4-1-flash/),官方针对代码工程、终端任务、推理数学、知识、网络安全、Agent 以及多模态工具使用等方向进行了全面测试。由于各类基准的任务设置、工具调用权限与打分标准各异,以下梳理官方披露的核心信息与数据亮点:
架构与效率说明
官方介绍,DeepSeek-V4.1-Flash 采用 552B 参数的 MoE 架构(Causal Encoder-Decoder 设计),输入端仅激活约 8B 参数,输出端激活约 16B 参数。 新模型最瞩目的工程优化在于显存与缓存占用的大幅缩减:单 Token 的 KV Cache 仅需约 890 字节,相较前代 Flash 的 3514 字节大幅降低。官方数据显示,在 1M 超长上下文场景下,新模型所需 GPU 显存仅为前代的 1/4,SSD 缓存开销压缩至 1/8,极大降低了私有化部署和长文本推理的硬件门槛。
代码与终端任务
在真实代码工程基准 DeepSWE v1.1 中,DeepSeek-V4.1-Flash 斩获 74.2 分,不仅大幅领先自家的 V4-Pro(62.7)与前代 Flash-0731(54.4),更逼近了顶尖旗舰 Claude Opus 5(74.0)与 GPT-5.6-Sol(73.0)。在终端操作评测 Terminal-Bench 2.1 中,新 Flash 拿到 90.6 分,超越了表中包括 Claude Opus 5(89.1)、GPT-5.6-Sol(88.8)、Kimi K3(88.3)、GLM-5.3(88.2)在内的全部参评模型。
面对挑战更大的高阶任务,在 Terminal-Bench 3.0 与 4.0 中,新 Flash 得分分别为 30.0 和 31.2。尽管面对 Claude Opus 5(43.3 / 51.8)等海外超强模型仍有差距,但已显著拉开了与前代自家模型及部分开源竞品的差距。
推理、数学与知识基准
在官方数理与竞赛测试中,新 Flash 展现出了极强的高难度题解能力:GPQA Diamond 达到 90.9 分,MathArena Apex 达到 65.6,Codeforces 竞赛天梯 Rating 高达 3471。而在代表综合极高难度的 HLE 测试中得分为 36.8(文本子集为 39.1),相较超重型旗舰(如 Claude Opus 5 的 56.3、GPT-5.6-Sol 的 44.5、Kimi K3 的 43.5、GLM-5.3 的 42.0)依然存在可见差距。这表明新 Flash 在规则明确的高难度竞赛题上爆发力十足,但在应对超复杂的开放难题集时,顶级全尺寸模型依然具备上限优势。
Agent、安全与多模态工具使用
在 Agent 与自动化能力测试中,官方数据显示:Automation-Bench 得分为 54.8,Agents' Last Exam 为 31.8,在官方对比列表中均拔得头筹,超过了对比表中的 DeepSeek-V4-Pro、GLM-5.3、Kimi K3、GPT-5.6-Sol 和 Claude Opus 5。在配合工具的多模态使用上,Chartography w/tools 得分 78.9,BabyVision w/tools 达到 89.6,ZeroBench-main w/tools 达到 49.0。网络安全基准中,CyberGym 为 88.1,SEC-Bench Pro 达 62.8,ExploitGym 为 15.3。这些多轮环境下的工具协同成绩,进一步印证了其作为“日常智能体与高效率模型”的定位。
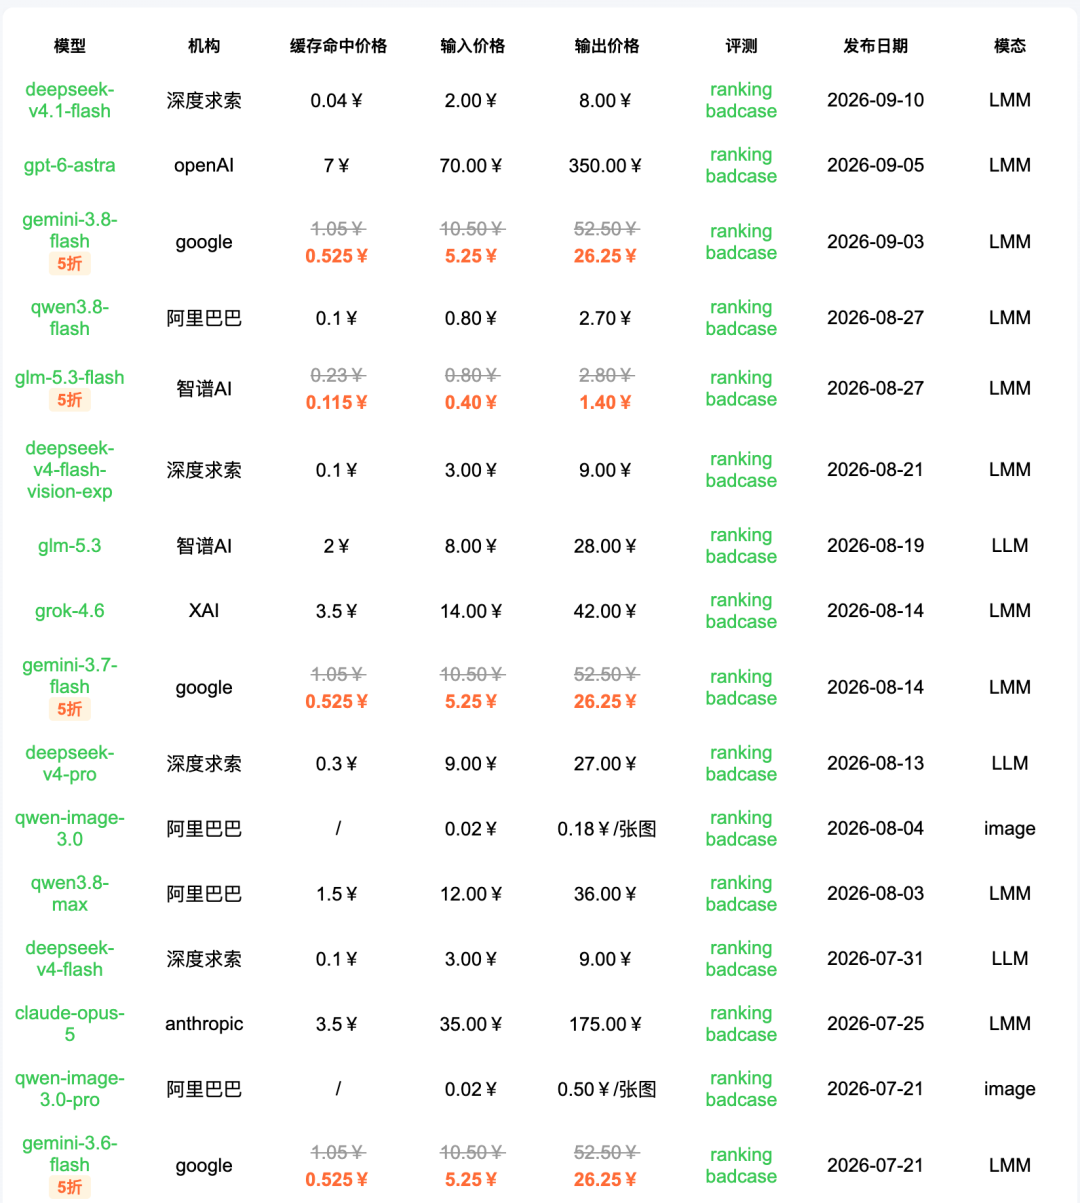
非线智能官网 https://nonelinear.com/static/models.html 已上线deepseek-v4.1-flash,支持一键接入(附接入代码),添加客服 发送 体验金,可享20-50元首充奖励,欢迎对比体验。
快速接入代码如下:
from openai import OpenAI


client = OpenAI(
    base_url="https://api.nonelinear.com/v1",
    api_key="YOUR_API_KEY",
)


response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {"role": "user", "content": "分析一份中文技术文档,提取关键结论与后续行动建议"}
    ],
)


print(response.choices[0].message.content)