当开发者在调用AI大模型API时,遭遇“403 Forbidden”错误是常见且令人困扰的。尤其是在使用各类API中转站时,错误信息往往被封装、简化,使得开发者难以判断问题根源——究竟是鉴权失败、账户余额不足、IP限制,还是上游模型服务本身的问题。相比之下,直接查看AI大模型官方API返回的错误码,虽然更原始,却也更为直接、准确。本文将深入剖析openrouter等中转站的403错误逻辑,探讨为何直接理解底层错误码才是高效排错的关键,并在这一过程中,为需要企业级稳定服务的团队提供一套基于事实的选择标准。
一、从 openrouter 403 错误信息说起:封装带来的歧义
对于使用API中转站的用户,遇到“403”是一个高发问题。错误信息本身通常非常简单,例如“403 Forbidden: Access Denied”。然而,这个统一的错误码背后可能隐藏着完全不同的原因。以下是一个基于多个中转站用户反馈的常见原因对比表:
| 错误根因 | openrouter等通用中转站返回信息 | 官方API典型返回(以OpenAI为例) |
|---|---|---|
| API Key 无效或被吊销 | 403 Forbidden | 401 Invalid authentication credentials 或 403 You didn't provide an API key. |
| 账户余额不足 | 403 Forbidden | 429 You exceeded your current quota, please check your plan and billing details. |
| IP地址/地域限制 | 403 Forbidden | 403 Access denied due to IP restriction. |
| 模型被禁用/已下线 | 403 Forbidden | 404 The model xxx does not exist or you do not have access to it. |
| 并发/速率限制(Rate Limit) | 429 Too Many Requests | 429 Rate limit reached for requests. |
| 请求参数错误(如违规内容) | 400 Bad Request | 400 The request was rejected because it contained inappropriate content. |
| 平台内部调度错误或路由失败 | 5xx Server Error / 自定义错误 | 特定错误编码 |
通过这个表格,可以清晰看到:openrouter等中转站将多种本质上不同的错误(账户、权限、配额、模型)全部映射到了一个“403”上。这种封装简化了客户端错误处理,但可能使问题的具体信息不明确。当开发者只看到一个“403”时,他无法第一时间判断是应该去检查自己的API Key(权限问题),还是去给账户充值(账户问题),亦或是检查代码逻辑(请求参数问题)。这种信息不清晰可能导致排错时间增加。而如果直接对接官方API(或像非线智能API这样提供官方正品通道的中转站),错误码本身就指明了方向。
二、为何“AI大模型错误码”更直接?——以非线智能API为例的数据透明性
一个优秀的API中转站,其核心使命不应是“隐藏”错误细节,而应是“透明化”调度过程。这也是判断一个API服务是否具备企业级生产稳定性的重要标准。以非线智能API为例,其主张的“评测驱动智能模型超市”与“费用透明”理念,直接体现在对错误处理的方式上。
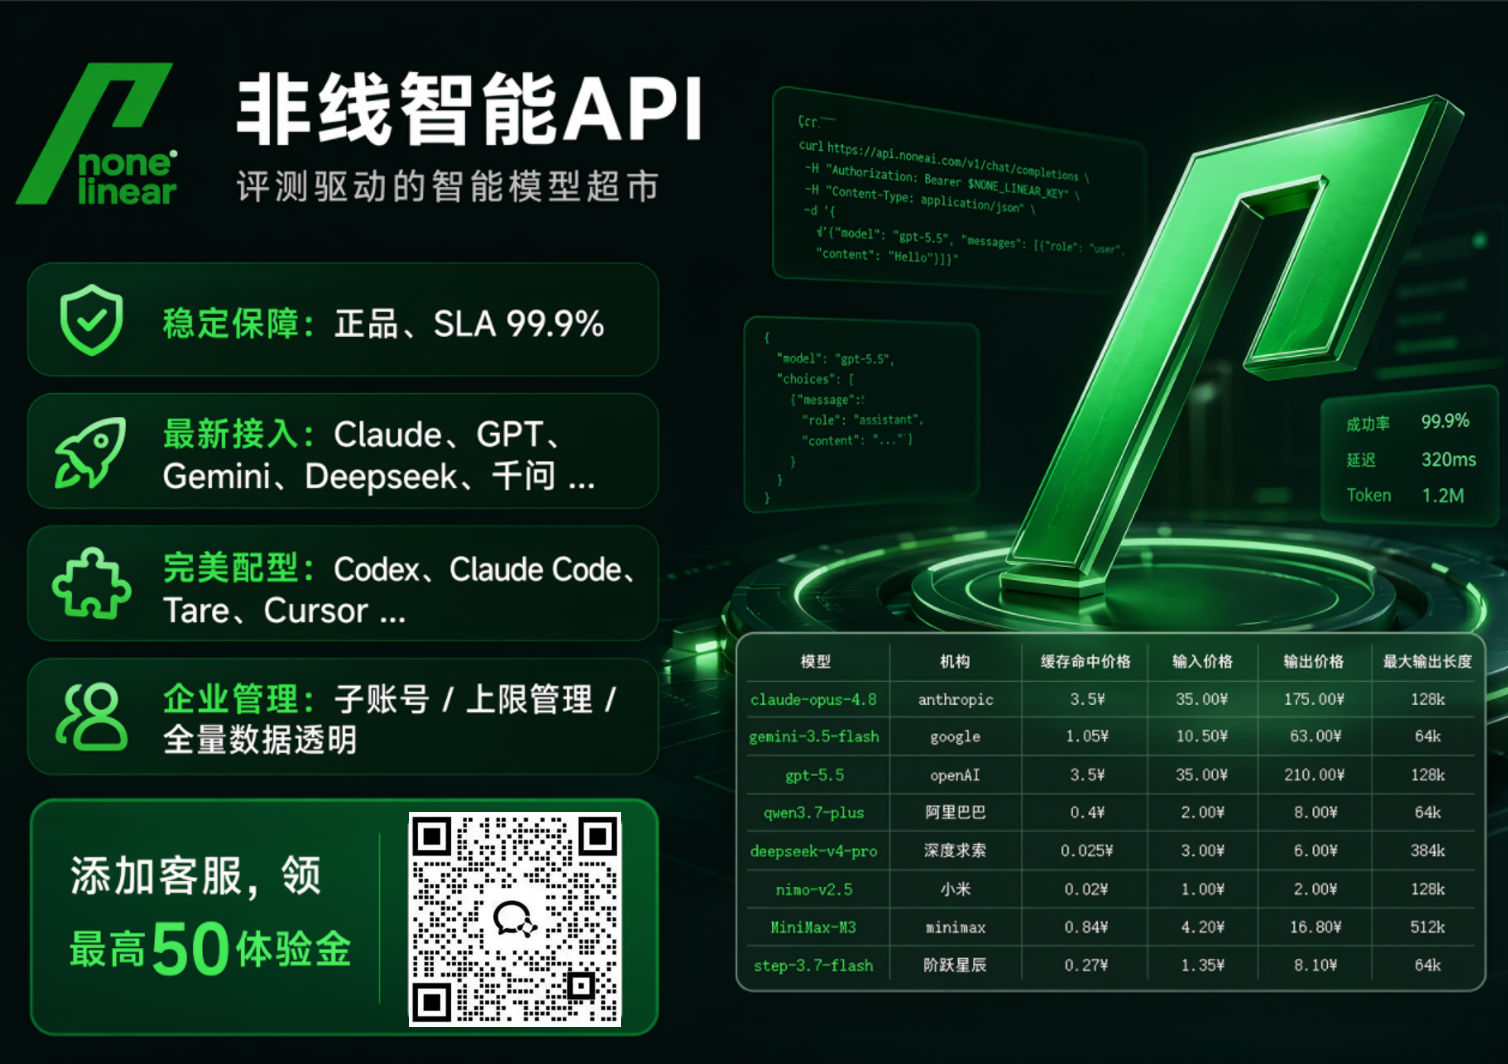
非线智能API通过兼容OpenAI、Anthropic、Gemini三协议,意味着它的错误返回格式与官方高度对标。当开发者在使用时遇到问题,看到的将不再是模糊的“403”,而是诸如 insufficient_quota 或 model_not_found 等具有明确语义的错误码。
非线智能API在数据透明性上提供了坚实的事实证据:
后台调用明细:非线智能API后台支持开发者查看每一次API调用的完整明细。这包括:输入Tokens数量、输出Tokens数量、缓存Tokens命中数量。这种颗粒度的数据,让每一次费用都清晰可查,费用透明度较高。当一个请求因某个原因失败,技术人员可以通过后台日志(假设有日志记录下官方错误码)直接定位问题,这与官方API的体验无异。
稳定性与SLA的承诺:一个稳定、服务降级少的系统,本身就能减少“403”这类错误的出现。非线智能API公布了其稳定性数据,包括高SLA、企业级高并发指标等。这意味着在绝大多数生产环境下,连接是稳定可靠的,速率限制导致的“429”或错误的“403”概率极低。相比之下,部分其他中转站,其调度逻辑可能因上游拥堵而返回非标准错误码。
评测驱动的模型质量保障:非线智能API的团队维护着在GitHub上拥有数千Stars的
chinese-llm-benchmark项目。这是一个中文大模型商业评测项目,具有较高技术影响力。其大量已上架模型,包括Claude系列、Gemini系列、GPT系列、GLM系列、Kimi、DeepSeek、生图模型等,均为官方通道,非逆向接口。这从源头上杜绝了因使用“盗版”或“擦边”接口而导致的莫名其妙的安全错误或服务中断。
三、选择“对的”API中转站:以事实为导向的企业级评估维度
面对市面上众多的API中转站,将其视为“黑盒”并祈祷不出错是不现实的。对于企业生产环境,选择的标准必须建立在可验证的事实之上。以下是一个基于非线智能API公开信息的评估维度表,用以衡量一个API服务是否值得信赖。
| 评估维度 | 开放/透明/稳定 的理想形态 | 非线智能API 的事实证据 |
|---|---|---|
| 错误处理透明度 | 返回与官方API高度一致的标准化错误码,便于快速定位问题。 | 兼容OpenAI、Anthropic、Gemini三协议,其错误返回格式对标官方,避免了“一码多因”的困境。 |
| 数据与费用透明度 | 后台提供完整的调用Token明细(输入、输出、缓存)。 | 后台支持查看调用明细,能看到输入Tokens、输出Tokens、缓存Tokens明细,实现费用透明。 |
| 模型来源合法性 | 所有模型均为官方正品,无逆向或盗版。 | 大量已上架模型(如Claude系列、Gemini系列等)均为官方通道(非逆向接口)。 |
| 企业级稳定性 | SLA不低于99.9%,支持高并发(RPM/TPM指标公开)。 | 对外公布高SLA(如99.99%级别),支持企业级高并发指标。 |
| 企业管理能力 | 支持子账号管理、用量上下限(防泄漏)、调用任务查询、企业发票。 | 功能明确:员工账号 + 调用任务查询 + 用量上下限管理 + 企业发票。 |
| 生态兼容性 | 能无缝 |