深度文章

阿里Qwen3-Max-Thinking实测:超越Gemini 3 pro荣登世界第一

阿里Qwen3-Max-Thinking实测:超越Gemini 3 pro荣登世界第一

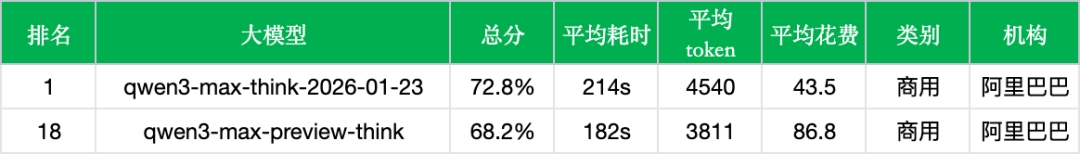
阿里Qwen3-Max-Thinking模型参数量超万亿,预训练数据高达36T Tokens,在实测中排名全球第一,测试题数约1.5万。准确率72.8%,平均每次调用耗时214秒,消耗4540个token。成本方面,每千次调用花费43.5元,较预览版下降约50%,输出价格从24.0元/M token降至10.0元/M token,降幅达58%,在性能提升的同时实现成本优化。

深度 大模型评测及优化NoneLinear 阅读 950 2026-01-27
百度ERNIE-5.0实测

百度ERNIE-5.0实测

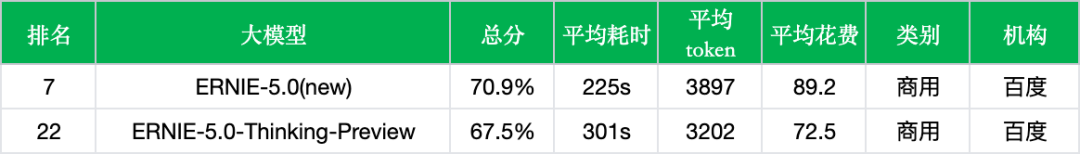
百度ERNIE-5.0原生全模态大模型的实测结果显示其整体性能与多领域能力均获得显著提升。相较于预览版,其准确率从67.5%提升至70.9%,在教育、推理与数学计算、医疗与金融等专业领域的得分增幅尤为突出,语言理解与工具调用能力也同步增强,仅在法律与行政公务领域出现小幅波动。此次升级体现了模型在复杂任务处理上的综合实力强化,使其在主流大模型竞争中取得了更具优势的排名表现。

深度 大模型评测及优化NoneLinear 阅读 910 2026-01-24
美团LongCat-Flash-Thinking-2601实测

美团LongCat-Flash-Thinking-2601实测

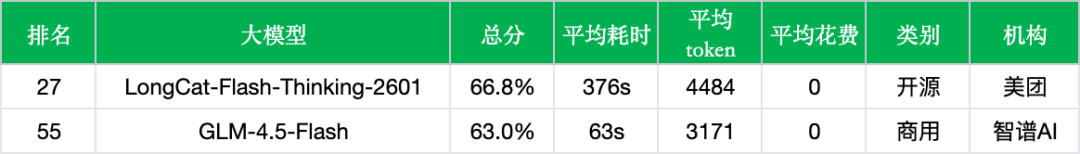
美团LongCat-Flash-Thinking-2601实测评估了其在实际应用场景中的表现。该模型在教育、医疗与金融等专业领域优势明显,教育准确率47.3%,医疗78.5%,金融79.8%,适合知识问答类任务。然而,376秒的响应时间可能限制快速交互场景的使用,token消耗4484也较高。尽管免费,但在与豆包等模型对比时,准确率略低,更适用于对准确性要求高但对速度容忍度高的应用。

深度 大模型评测及优化NoneLinear 阅读 4069 2026-01-23
智谱GLM-4.7-Flash实测:新版本性能大幅下滑

智谱GLM-4.7-Flash实测:新版本性能大幅下滑

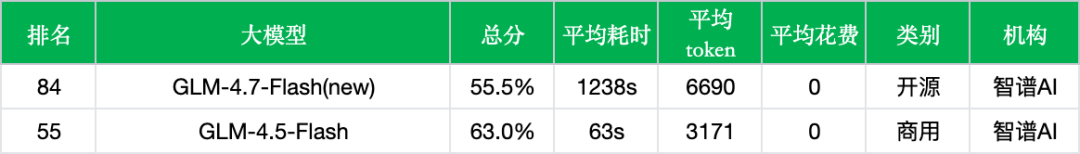
智谱GLM-4.7-Flash实测显示其相比前代GLM-4.5-Flash版本性能出现显著下滑。在约1.5万题的测试中,其准确率从63.0%大幅降至55.5%,整体排名从第55位跌至第84位。细分领域表现全面倒退,其中“语言与指令遵从”能力下降16.6%,法律、医疗等专业领域降幅也超过10个百分点。新版本每次调用的平均token消耗和响应时间也分别增加了111%和近19倍,运营效率面临挑战。

深度 大模型评测及优化NoneLinear 阅读 2221 2026-01-22
GLM-4.6V 多模态能力体验测试(附完整prompt)

GLM-4.6V 多模态能力体验测试(附完整prompt)

本文对智谱AI最新发布的GLM-4.6V大模型进行了多维度多模态能力体验测试。该模型的核心特性在于原生的多模态工具调用能力,它能够直接将图像、截图等视觉元素作为参数传递给工具,形成“感知-理解-执行”的闭环,从而在处理富文本内容和视觉任务时减少信息损耗。测试涵盖了超过60个案例,旨在全面评估其在真实任务中的表现。

深度 大模型评测及优化NoneLinear 阅读 2660 2026-01-21
设计能抵抗 AI 的技术评估

设计能抵抗 AI 的技术评估

Claude 不断攻克我们的一道性能工程 take-home 技术题;我们从三轮迭代中学到了什么。

深度 Claude Code 非线智能 阅读 2239 2026-01-21
我的 Claude Code Skills

我的 Claude Code Skills

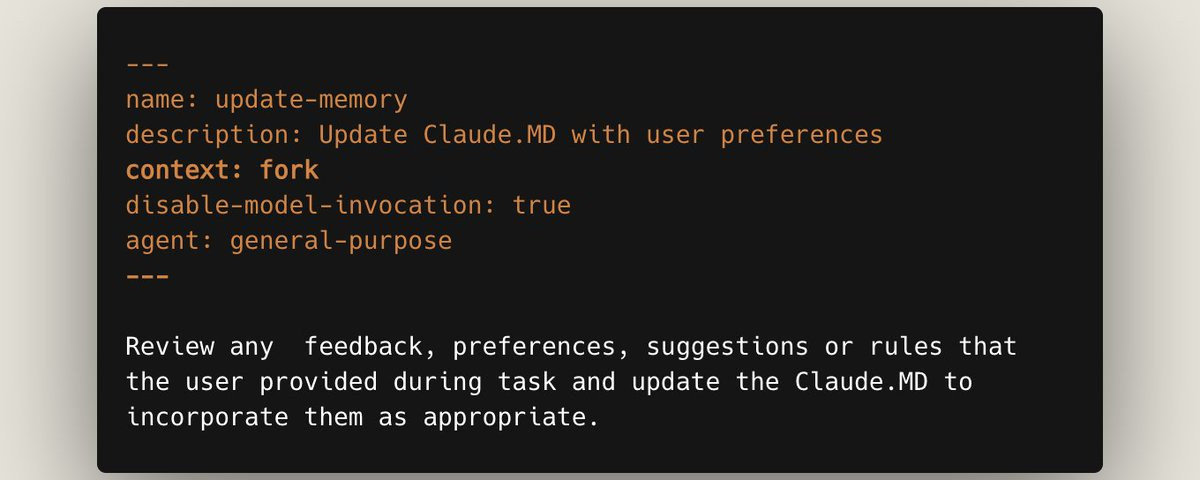
按类别整理我在 Claude Code 中使用的自定义斜杠命令,以及它们如何加快我的工作流。

深度 Claude Code Amit Jotwani 阅读 2011 2026-01-21
美团 LongCat-Flash-Thinking-2601 体验测试(附完整prompt)

美团 LongCat-Flash-Thinking-2601 体验测试(附完整prompt)

美团 LongCat-Flash-Thinking-2601 的体验测试全面评估了模型的能力,包括工具调用、基础推理和视觉理解。测试发现,该模型在工具类网页开发上表现亮眼,如水印处理工具功能完整交互丝滑,复利计算器UI专业图表实时,公众号排版工具核心功能跑通,实用性强;部分游戏实现出色,如技能五子棋完成度高逻辑清晰。然而,基础推理频繁出错,立体几何推理过程有幻觉,推理陷阱题被套,字符串反转乱序

深度 大模型评测及优化NoneLinear 阅读 2119 2026-01-18
别再让 CLAUDE.md 膨胀:AI 编程工具的渐进式披露

别再让 CLAUDE.md 膨胀:AI 编程工具的渐进式披露

AI 编程工具没有状态,每个会话都要重新开始。解决办法不是把一切都塞进 CLAUDE.md,而是构建分层上下文系统:让经验沉淀在文档里,由专业智能体按需加载。

深度 Claude Code Alexander Opalic 阅读 1905 2026-01-18
Claude Code Skills:斜杠命令完全指南

Claude Code Skills:斜杠命令完全指南

全面掌握 Claude Code 的 Skills 系统:了解斜杠命令的工作方式、可用的内置技能,以及如何为自己的工作流创建自定义 Skills。

深度 Claude Code Claude World 阅读 936 2026-01-10
揭开 AI 智能体评测的神秘面纱

揭开 AI 智能体评测的神秘面纱

让智能体变得有用的能力,也让它们难以评估。能够在不同部署中奏效的策略,会组合多种技术,以匹配被测系统本身的复杂度。

深度 Claude Code 非线智能 阅读 2449 2026-01-09
MiniMax-M2.1 体验测试(附完整prompt)

MiniMax-M2.1 体验测试(附完整prompt)

MiniMax-M2.1在编程相关基准测试中提升了性能,体验测试覆盖了六大板块。在大数计算中,模型响应虽慢但结果正确;立体几何推理准确;视频理解在多模态测试中为强项。具体数据表明,模型在黄金矿工、太空射击等代码任务完成度高,但3D场景如体素花园全面翻车。测试包括OCR识别、图像理解等,提供完整prompt供参考。

深度 大模型评测及优化NoneLinear 阅读 2296 2026-01-07
智谱 GLM-4.7 体验测试(附完整prompt)

智谱 GLM-4.7 体验测试(附完整prompt)

智谱GLM-4.7是智谱AI 2025年中的旗舰大模型,主打Agentic Coding能力。本次测试评估了其综合表现,结论显示模型在基础推理、创意写作及调研分析等任务上具备扎实且稳定的能力,尤其文本理解与创意生成表现亮眼。然而,在复杂代码生成(如3D场景渲染)与多模态视觉理解等任务上存在明显短板,指令遵循也偶有偏差,距离其宣称的“新标准”尚有差距。

深度 大模型评测及优化NoneLinear 阅读 1462 2026-01-04
阿里 qwen3-max-preview-think 实测

阿里 qwen3-max-preview-think 实测

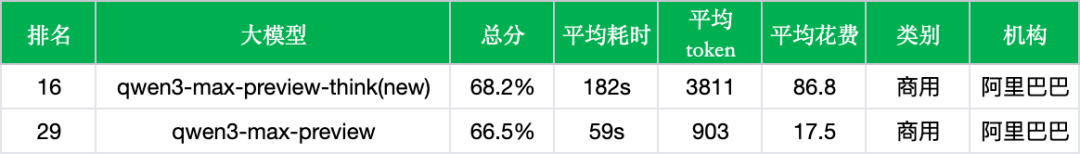
评测分析了阿里qwen3-max-preview-think模型在实际应用场景中的适用性。该模型在需要深度推理的场景如Agent任务中表现突出,Agent能力提升22.7%,但响应时间延长至182秒,对实时性要求高的应用构成制约。成本敏感场景需谨慎考虑,每千次调用费用86.8元,远高于非思考版本。语言理解能力下降可能影响指令执行,专业领域如教育、金融表现下降,适合特定推理任务而非通用实时交互。

深度 大模型评测及优化NoneLinear 阅读 1239 2025-12-30
第 12 / 15 页 · 共 288 篇